原文載點:http://support.sas.com/resources/papers/proceedings15/3367-2015.pdf
冒號( : )在SAS的資料處理中扮演了一個鮮為人知的角色。這一篇2015年在SAS Global Forum發表的技術文件介紹了如何適當的使用冒號在SAS程式裡面。我列了幾個一般使用者比較會用到的功能。
2015年8月30日 星期日


2013年7月19日 星期五
CREATING MACRO VARIABLES VIA PROC SQL
文章來源:http://www.ats.ucla.edu/stat/sas/library/nesug99/cc107.pdf
在 SAS 裡面製作巨集變數,常用的方法不外乎是用 %let 或者是 %symput 來宣告,但功能就僅僅於此了。不過,若使用 PROC SQL 程序來宣告巨集變數的話,可以做些變化來提升程式寫作效率。
2011年5月28日 星期六
Automagically Copying and Pasting Variable Names
原文載點:http://support.sas.com/resources/papers/proceedings10/046-2010.pdf
如果使用者從第三處拿到一筆資料,想要建立coding book或目錄,或者需要寫新的程式必且在keep或drop指令輸入大量變數名稱,因而需要大量複製和貼上變數名稱的話,有什麼比較好的方法呢?Arthur S. Tabachneck 等人提供了一個方法讓使用者能夠一次複製且貼上全部的變數名稱。
如果使用者從第三處拿到一筆資料,想要建立coding book或目錄,或者需要寫新的程式必且在keep或drop指令輸入大量變數名稱,因而需要大量複製和貼上變數名稱的話,有什麼比較好的方法呢?Arthur S. Tabachneck 等人提供了一個方法讓使用者能夠一次複製且貼上全部的變數名稱。
2011年4月3日 星期日
So Many Variables; Too Many Labels, Moving Labels from One Variable to Another
原文載點:http://support.sas.com/resources/papers/proceedings10/047-2010.pdf
在 SAS 資料處理的過程中,使用者會發現,當複製一個變數並給予新的變數名稱時,舊變數的格式雖然會一併複製到新變數裡面,但舊變數的 label 卻沒有辦法複製過去。若只有一兩個變數時還可以用手動的方式在 data step 裡面重打,但若變數過多時,這就會成為一個相當棘手的問題。John Ladds 提供了一個簡易的方式來解決這個 label 複製的問題。
在 SAS 資料處理的過程中,使用者會發現,當複製一個變數並給予新的變數名稱時,舊變數的格式雖然會一併複製到新變數裡面,但舊變數的 label 卻沒有辦法複製過去。若只有一兩個變數時還可以用手動的方式在 data step 裡面重打,但若變數過多時,這就會成為一個相當棘手的問題。John Ladds 提供了一個簡易的方式來解決這個 label 複製的問題。
2010年7月23日 星期五
Stupid Human Tricks with PROC EXPAND®
Link: http://support.sas.com/resources/papers/proceedings10/093-2010.pdf
鮮少有人知道 SAS/ETS 裡面有個叫做 PROC EXPAND 的程序。這個程序主要是用來整理時間序列資料,比方說可以自己定義時間區間後再來做一些次數量表的製作。David L. Cassell 利用這個程序進行了一些平常使用者可以用來做資料處理的功能,並發表了一篇教學文件在 SAS GLOBAL FORUM 2010 上。讓我們來看看如何用 PROC EXPAND 程序來取代一些複雜的資料操作。
鮮少有人知道 SAS/ETS 裡面有個叫做 PROC EXPAND 的程序。這個程序主要是用來整理時間序列資料,比方說可以自己定義時間區間後再來做一些次數量表的製作。David L. Cassell 利用這個程序進行了一些平常使用者可以用來做資料處理的功能,並發表了一篇教學文件在 SAS GLOBAL FORUM 2010 上。讓我們來看看如何用 PROC EXPAND 程序來取代一些複雜的資料操作。
Dropping Automatically Variables with Only Missing Values
Link: http://support.sas.com/resources/papers/proceedings10/048-2010.pdf
在進行資料分析前,有些人會習慣把一些含有missing data的樣本給清除掉,雖然這不會影響到分析結果,因為大部分的SAS程序都是用CCA(Complete Case Analysis)來處理含有missing data的數據,不過若要用手動的方法來清掉missing data的話,在遇到龐大數量的變數時,需要消耗很多時間在輸入遍數名稱上。美國人口普查局的Selvaratnam Sridharma發表了一個macro程序於SAS Global Forum 2010,讓這個程式撰寫的過程只需要幾秒鐘的時間就可以完成。
在進行資料分析前,有些人會習慣把一些含有missing data的樣本給清除掉,雖然這不會影響到分析結果,因為大部分的SAS程序都是用CCA(Complete Case Analysis)來處理含有missing data的數據,不過若要用手動的方法來清掉missing data的話,在遇到龐大數量的變數時,需要消耗很多時間在輸入遍數名稱上。美國人口普查局的Selvaratnam Sridharma發表了一個macro程序於SAS Global Forum 2010,讓這個程式撰寫的過程只需要幾秒鐘的時間就可以完成。
2008年11月10日 星期一
Combining, Combining, Combining, Splitting, Splitting, Splitting
原文載點:http://www.nesug.info/Proceedings/nesug06/dm/da30.pdf
這是一篇教導如何使用 data step 和 proc sql 合併和分割資料的 SAS 技術文件,由 Emmy Pahmer 於 NESUG 2006 發表。
本文所使用的範例如下:

這筆資料總共只有五個觀測值,每個觀測值包含三個變數:年齡、姓名和性別。其中第五個觀測值的性別是打錯的 G。
。分割資料
若想要將上述資料依照性別切割成兩個分開的資料集,則有下列幾種方式。
1. 使用兩個 data step:這是最笨但也是最直接的方式。程式碼如下所示:
2. 使用兩個 data step 配合 where:這個方法僅僅是縮短程式碼行數。程式碼如下:
有此程式可知,這只是把 IF 的指令改成 WHERE 並放在 SET 後面。對行數來說,的確是減少了,不過打的字變多了,因為 WHERE 後面的條件式要加上括弧。
3. 使用兩個 data step 配合 where:這個方法僅僅是把 WHERE 從 SET 移到 DATA 後面,並沒有太特別的地方。程式碼如下:
4. 使用一個 data step 並配合 IF...ELSE... 和 OUTPUT:這是比較進階的方式,可以大幅縮短程式碼的行數。如下所示:
由於本資料中某觀測值的性別是打錯的。為了確定有沒有這類的情況,當資料相當龐大時,建議使用下列程式碼:
其中紅色那行的程式碼會讓性別變數不是 F 和 M 的觀測值通通分類到 _all_ 這個資料集中。亦或是另外定義一個資料集把他們 output 進去。當打開這個資料集時,如果裡面是空的,就可以確定沒有打錯的情況產生。
5. 使用一個 data step 並配合 WHERE:這是從方法二改良來。程式碼如下:
這個程式碼比方法四 要來的更精簡精簡。如果想要擁有方法三第二個可以偵測有沒有打錯的資料,則可以改進如下:
道理同方法四,把 sex 不是 M 和 F 的通通丟到 checkothers 這個資料集裡面,然後再去看看該資料集是不是空的。
6. 使用 proc sql:使用 proc sql 看起來好像比較高檔,但是行數並沒有減少。
7. 使用一個 data step 把 不同的變數放到不同的資料集:若想要把 who 和 age 放到新資料集 age,然後再把 who 和 sex 放到新資料集 sex,則可仿照方法五來切割。程式如下:
8. 使用 proc sql 完成方法七:程式如下:
感覺行數沒有減少很多,只是寫法比較接近口語。
。合併資料
這回使用兩筆資料,如下所示:

其中 EVERYONE 這筆和之前用的一樣,而新的 ACTIVITY 資料有一點要特別注意的是它並沒有排序過。為什麼要特別強調這一點,理由是在 SAS 的合併過程中,一定要設定一個 index variable,這樣 SAS 才有辦法依照那個 index variable 來進行資料合併。而那個被設定成 index variable 的變數一定要經過排序,否則 SAS 在合併的過程中會錯亂掉。這個錯亂有時候還是會給你 output,只是結果是錯的。如果一時忽略沒有看到 log 視窗上面的警告訊息,就完蛋了。因此若要依照「who」這個變數來合併這兩組資料,則必須要先用 PROC SORT 把該變數排序:
而通常要養成一個好習慣就是所有合併的資料最好都給他排序一下,免得有漏網之魚。反正 PROC SORT 的程式碼很簡單,多寫幾行比較安心:
然後用 merge 和 by 來合併:
結果如下:

從上表得知,Annie, Bill, Chandra, Igor, Jose 和 Karen 在 ACTIVITY 裡面有資料,所以合併時會顯示在 activity 這個變數底下,但 David 和 Eleanor 則沒有出現在 ACTIVITY 裡面,所以合併後他們兩人的 activity 變數就變成 missing data 了。Age 也是同樣的道理。
如果只想顯示同時出現在兩個資料的觀測值,則必須啟用 in 這個指令。程式碼如下:
使用 in 這個指令會讓 SAS 在合併的過程中,於兩組資料裡面各加上一個隱藏的變數,分別名為 in_a 和 in_b,其數值都預設為 1。合併之後在程式裡面加上「if in_a and in_b;」來讓 SAS 挑出同時具有 in_a=1 和 in_b=1 的觀測值(要打成「if in_a=1 and in_b=1;」也可以),缺少任一個變數的觀測值則會自動被剔除。結果如下:

如果想要知道哪些觀測值被剔除,可使用下列程式碼:
最後那兩個 else if... 會讓程式在 log 視窗印出下列字樣:

同樣地,proc sql 也可達成同樣效果:
或者
但由於 proc sql 的指令比較麻煩,所以還是建議使用 data step 來完成。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Emmy Pahmer
MDS Pharma Services
St. Laurent, Québec
Work Phone: (514) 333-0042 ext. 4222
E-mail: emmy.pahmer@mdsinc.com
這是一篇教導如何使用 data step 和 proc sql 合併和分割資料的 SAS 技術文件,由 Emmy Pahmer 於 NESUG 2006 發表。
本文所使用的範例如下:
這筆資料總共只有五個觀測值,每個觀測值包含三個變數:年齡、姓名和性別。其中第五個觀測值的性別是打錯的 G。
。分割資料
若想要將上述資料依照性別切割成兩個分開的資料集,則有下列幾種方式。
1. 使用兩個 data step:這是最笨但也是最直接的方式。程式碼如下所示:
data males;
    set everyone;
    if sex = 'M';
run;
data females;
    set everyone;
    if sex = 'F';
run;
2. 使用兩個 data step 配合 where:這個方法僅僅是縮短程式碼行數。程式碼如下:
data female;
    set everyone (where=(sex=’F’)) ;
run;
data male;
    set everyone (where=(sex=’M’)) ;
run;
有此程式可知,這只是把 IF 的指令改成 WHERE 並放在 SET 後面。對行數來說,的確是減少了,不過打的字變多了,因為 WHERE 後面的條件式要加上括弧。
3. 使用兩個 data step 配合 where:這個方法僅僅是把 WHERE 從 SET 移到 DATA 後面,並沒有太特別的地方。程式碼如下:
data female (where= (sex = ‘F’)) ;
    set everyone ;
run;
data male (where= (sex = ‘M’)) ;
    set everyone ;
run;
4. 使用一個 data step 並配合 IF...ELSE... 和 OUTPUT:這是比較進階的方式,可以大幅縮短程式碼的行數。如下所示:
data males females;
    set everyone;
    if sex = 'F' then output females;
    else if sex = 'M' then output males;
run;
由於本資料中某觀測值的性別是打錯的。為了確定有沒有這類的情況,當資料相當龐大時,建議使用下列程式碼:
data males females;
    set everyone;
    if sex = 'F' then output females;
        else if sex = 'M' then output males;
            else put “Neither F nor M - check “ _all_; *or output to another dataset ;
run;
其中紅色那行的程式碼會讓性別變數不是 F 和 M 的觀測值通通分類到 _all_ 這個資料集中。亦或是另外定義一個資料集把他們 output 進去。當打開這個資料集時,如果裡面是空的,就可以確定沒有打錯的情況產生。
5. 使用一個 data step 並配合 WHERE:這是從方法二改良來。程式碼如下:
data female (where=(sex=’F’)) male (where=(sex=’M’)) ;
    set everyone ;
run;
這個程式碼比方法四 要來的更精簡精簡。如果想要擁有方法三第二個可以偵測有沒有打錯的資料,則可以改進如下:
data female (where=(sex=’F’)) male (where=(sex=’M’)) checkothers (where = (sex not in (‘M’,’F’))) ;
    set everyone ;
run;
道理同方法四,把 sex 不是 M 和 F 的通通丟到 checkothers 這個資料集裡面,然後再去看看該資料集是不是空的。
6. 使用 proc sql:使用 proc sql 看起來好像比較高檔,但是行數並沒有減少。
proc sql;
    create table males as
    select *
    from everyone (where=(sex='M'));
    create table females as
    select *
    from everyone (where=(sex='F'));
quit;
7. 使用一個 data step 把 不同的變數放到不同的資料集:若想要把 who 和 age 放到新資料集 age,然後再把 who 和 sex 放到新資料集 sex,則可仿照方法五來切割。程式如下:
data age (keep = who age) sex (keep = who sex);
    set everyone;
run;
8. 使用 proc sql 完成方法七:程式如下:
proc sql;
    create table age as
    select who, age
    from everyone;
    create table sex as
    select who, sex
    from everyone;
quit;
感覺行數沒有減少很多,只是寫法比較接近口語。
。合併資料
這回使用兩筆資料,如下所示:
其中 EVERYONE 這筆和之前用的一樣,而新的 ACTIVITY 資料有一點要特別注意的是它並沒有排序過。為什麼要特別強調這一點,理由是在 SAS 的合併過程中,一定要設定一個 index variable,這樣 SAS 才有辦法依照那個 index variable 來進行資料合併。而那個被設定成 index variable 的變數一定要經過排序,否則 SAS 在合併的過程中會錯亂掉。這個錯亂有時候還是會給你 output,只是結果是錯的。如果一時忽略沒有看到 log 視窗上面的警告訊息,就完蛋了。因此若要依照「who」這個變數來合併這兩組資料,則必須要先用 PROC SORT 把該變數排序:
proc sort data=activity;
    by who;
run;
而通常要養成一個好習慣就是所有合併的資料最好都給他排序一下,免得有漏網之魚。反正 PROC SORT 的程式碼很簡單,多寫幾行比較安心:
proc sort data=everyone;
    by who;
run;
然後用 merge 和 by 來合併:
data combined_11;
    merge everyone activity;
    by who;
run;
結果如下:
從上表得知,Annie, Bill, Chandra, Igor, Jose 和 Karen 在 ACTIVITY 裡面有資料,所以合併時會顯示在 activity 這個變數底下,但 David 和 Eleanor 則沒有出現在 ACTIVITY 裡面,所以合併後他們兩人的 activity 變數就變成 missing data 了。Age 也是同樣的道理。
如果只想顯示同時出現在兩個資料的觀測值,則必須啟用 in 這個指令。程式碼如下:
data combined_12;
    merge everyone (in = in_a) activity (in = in_b);
    by who;
    if in_a and in_b;
run;
使用 in 這個指令會讓 SAS 在合併的過程中,於兩組資料裡面各加上一個隱藏的變數,分別名為 in_a 和 in_b,其數值都預設為 1。合併之後在程式裡面加上「if in_a and in_b;」來讓 SAS 挑出同時具有 in_a=1 和 in_b=1 的觀測值(要打成「if in_a=1 and in_b=1;」也可以),缺少任一個變數的觀測值則會自動被剔除。結果如下:
如果想要知道哪些觀測值被剔除,可使用下列程式碼:
data combined_14;
    merge everyone (in = in_a) activity (in = in_b);
    by who;
    if in_a and in_b then output;
        else if in_a then put "In A only: " Who=; *or output to another dataset ;
            else if in_b then put "In B only: " Who=;
run;
最後那兩個 else if... 會讓程式在 log 視窗印出下列字樣:
同樣地,proc sql 也可達成同樣效果:
proc sql;
    create table combined_15a as
    select a.*, b.activity, b.sex
    from everyone as a, activity as b
    where a.who = b.who
    order by activity
    ;
quit;
或者
proc sql;
    create table combine_15b as
    select a.*, b.activity, b.sex
    from everyone as a inner join activity as b
    on a.who = b.who
    ;
quit;
但由於 proc sql 的指令比較麻煩,所以還是建議使用 data step 來完成。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Emmy Pahmer
MDS Pharma Services
St. Laurent, Québec
Work Phone: (514) 333-0042 ext. 4222
E-mail: emmy.pahmer@mdsinc.com
2008年9月11日 星期四
Names, Names, Names - Make Me a List
原文載點:http://www2.sas.com/proceedings/forum2007/052-2007.pdf
如果你曾經讀過去年的這一篇文章「Text Utility Macros for Manipulating Lists of Variable Names」,而且也親自使用過該原文作者所提供的 text utility macro 的話,想必一定會對其強大的批次 rename 功能印象深刻。不過這個 macro 有個缺點,那就是在使用前要先定義這個東西:
這個 %let 的作用是把所有原始變數集中定義成 orig_vars 這個變數,然後再讓 text utility 來使用。不過,如果當變數很多時,我們需要手動去輸入,仍舊是相當耗時。而之前我曾經發過這篇文章「Automatically Renaming Common Variables Before Merging」,裡面是利用 PROC SQL 來抓出舊變數名稱。不過,如果舊變數名稱是有規則可尋,比方說 y1~y1000 時( %let 不允許使用 y1-y1000 這種寫法),則這篇在 SAS Global Forum 2007 由 Ian Whitlock 發表的技術文件可以有很大的幫助。
這篇技術文件一共發佈了五個有用的 macro 讓使用者可以輕易操作大量變數名稱。以下就一一介紹:
。%ZIP
這個 macro 顧名思義就和壓縮檔 zip 一樣,可以組合數個不同的變數或 index 來產生有規則的變數。語法如下:
變數解釋如下:
。l1= 第一列字串
。lv1= 取代第一列字串的字串(可省略不用)
。sep1= 用來區隔第一列字串的字元,預設值是空白(%str())
。l2= 第二列字串
。lv2= 取代第二列字串的字串(可省略不用)
。sep2= 用來區隔第二列字串的字元,預設值是空白(%str())
。osep= 用來區隔輸出字串的字元,預設值是空白(%str())
比方說想要生成「Ax By Cz」這三個字串,可使用下列程式:
l1 所表示的「A B C」會去抓在 l2 相對應位置的「x y z」,這便是 %zip 所呈現的功能。
。XPROD
這是可以拿來產生連續字尾或字首的 macro。語法如下:
使用方式和 %zip 一模一樣,但產生出來的效果完全不同。比方說想要產生「lib.w1 lib.w2 lib.w3」這三個字串,可發現這三個字串只有尾數不同,所以可以用 %xprod 來產生:
換句話說,在 %xprod 裡面,l1 是拿來放共同字串,l2 是拿來放會改變的字串。他甚至可以做出更複雜的效果。假設想要產生「a_x a_y b_x b_y c_x c_y」這六個字串,我們可以想像這是一個 3X2 的矩陣:
而實際上 %xprod 就是用這種原理去做字串合併,因此我們只需要輸入:
就可自動產生那六個字串出來。
。RANGE
這是拿來生成連續數字的程式。語法如下:
變數解釋:
。to= 連續數字最後一位數,預設值是 1
。from= 連續數字的第一位數,預設值是 1
。step= 跳號的間格數,預設值是 1
。sep= 分隔連續數字的字元,預設值是空格(%str( ))
顧名思義,如果要生出「1 2 3 4 5」這串連續數字,則可使用:
。REPLACE
這是拿來取代字元的 macro,特別是使用在重新命名的動作裡面。語法如下:
變數解釋:
。l= 輸入字串
。lv= 取代上列字串的字串(可省略不用)
。code= 包含 key 所代表的符號變數的字串,通常是在程式中不會被變動的字串
。key= 用來當作取代「l」代表的字串的符號變數,預設值是 #
。lsep= 用來區隔輸入字串的字元,預設值是空白(%str())
。osep= 用來區隔輸出字串的字元,預設值是空白(%str())
舉例來說,如果在套入一組資料時要順便改變某些變數名稱,則程式碼為:
則可使用 %replace 來簡化:
這個程式會先把 l 所定義的 x y z 用依序一個 # 來取代,而 code 的作用就是把 x y z 一一套入「#=__#」的框架裡面,進而產生「x=__x y=__y z=__z」這三個字串出來。
另外還有更進階的寫法,就是把 %replace 放進另一個自創的 %rename 裡面,程式如下:
%rename 的第一個參數就等於 %replace 的第一個參數,而 pref 就等於輸出字串裡面共有的字串(此例預設值是「__」)。因此原來的程式可以更簡化為:
這時「x y z」就等於「list」,也等於「l」,而 pref 所表示的「__」被丟進 %replace 的 code 參數裡面,則 code 就變成「code= #=__#」,這就便回原來只用 %replace 的那個程式碼了。
%replace 也可以使用在變數轉換上面。比方說上面這個例子,在 rename 後要把新變數轉換成 best 32. 的格式。如果不用額外的 macro 則語法是:
同樣地,我們可以另外自製一個命為 %CHAR2NUM 的 macro,然後套用 %replace 去寫。方法如下:
這個新 macro 的參數用法和 %rename 一樣,但我們來看看 %replace 在裡面發會什麼功用。l 去呼叫 list 所定義的字串,而 code 生出「#=input(&pref#,best32.);」,其中 # 就是暫時替代 l/list 參數所定義的字串,pref 是利用預設值「__」,則 code 其實就是產生下面這三行:
因此原本的程式可以改寫成:
。QT
這個 macro 只是很簡單地幫每個字元加上雙引號。語法如下:
變數解釋:
。l= 輸入字串
。lv= 取代上列字串的字串(可省略不用)
。lsep= 用來區隔輸入字串的字元,預設值是空白(%str())
。qt= 幫每個字元左右加上的符號,預設值是雙引號(")
。osep= 用來區隔輸出字串的字元,預設值是空白(%str())
因此,如果要生成出「"a" "b" "c"」只需要簡單地使用:
以下是各 macro 的原始碼:
。ZIP
。XPROD
%RANGE
。REPLACE
Contact information
Ian Whitlock
29 Lonsdale Lane
Kennett Square, PA 19348
Ian.Whitlock@comcast.net
如果你曾經讀過去年的這一篇文章「Text Utility Macros for Manipulating Lists of Variable Names」,而且也親自使用過該原文作者所提供的 text utility macro 的話,想必一定會對其強大的批次 rename 功能印象深刻。不過這個 macro 有個缺點,那就是在使用前要先定義這個東西:
%let orig_vars = a01a a01b d01 d02 t1_r t2_r;這個 %let 的作用是把所有原始變數集中定義成 orig_vars 這個變數,然後再讓 text utility 來使用。不過,如果當變數很多時,我們需要手動去輸入,仍舊是相當耗時。而之前我曾經發過這篇文章「Automatically Renaming Common Variables Before Merging」,裡面是利用 PROC SQL 來抓出舊變數名稱。不過,如果舊變數名稱是有規則可尋,比方說 y1~y1000 時( %let 不允許使用 y1-y1000 這種寫法),則這篇在 SAS Global Forum 2007 由 Ian Whitlock 發表的技術文件可以有很大的幫助。
這篇技術文件一共發佈了五個有用的 macro 讓使用者可以輕易操作大量變數名稱。以下就一一介紹:
。%ZIP
這個 macro 顧名思義就和壓縮檔 zip 一樣,可以組合數個不同的變數或 index 來產生有規則的變數。語法如下:
%zip (l1= , lv1= , sep1=, l2= , lv2= , sep2= , osep= )變數解釋如下:
。l1= 第一列字串
。lv1= 取代第一列字串的字串(可省略不用)
。sep1= 用來區隔第一列字串的字元,預設值是空白(%str())
。l2= 第二列字串
。lv2= 取代第二列字串的字串(可省略不用)
。sep2= 用來區隔第二列字串的字元,預設值是空白(%str())
。osep= 用來區隔輸出字串的字元,預設值是空白(%str())
比方說想要生成「Ax By Cz」這三個字串,可使用下列程式:
%zip(l1=A B C, l2=x y z);l1 所表示的「A B C」會去抓在 l2 相對應位置的「x y z」,這便是 %zip 所呈現的功能。
。XPROD
這是可以拿來產生連續字尾或字首的 macro。語法如下:
%xprod ( l1= , lv1= , l2= , lv2=, sep1=, sep2=, osep=) )使用方式和 %zip 一模一樣,但產生出來的效果完全不同。比方說想要產生「lib.w1 lib.w2 lib.w3」這三個字串,可發現這三個字串只有尾數不同,所以可以用 %xprod 來產生:
%xprod(l1=lib.w, l2=1 2 3);換句話說,在 %xprod 裡面,l1 是拿來放共同字串,l2 是拿來放會改變的字串。他甚至可以做出更複雜的效果。假設想要產生「a_x a_y b_x b_y c_x c_y」這六個字串,我們可以想像這是一個 3X2 的矩陣:
      x   y
a_
b_
c_
而實際上 %xprod 就是用這種原理去做字串合併,因此我們只需要輸入:
%xprod(l1=a_ b_ c_, l2=x y);就可自動產生那六個字串出來。
。RANGE
這是拿來生成連續數字的程式。語法如下:
%range ( to=, from= , step= , sep= )變數解釋:
。to= 連續數字最後一位數,預設值是 1
。from= 連續數字的第一位數,預設值是 1
。step= 跳號的間格數,預設值是 1
。sep= 分隔連續數字的字元,預設值是空格(%str( ))
顧名思義,如果要生出「1 2 3 4 5」這串連續數字,則可使用:
%range(to=5);。REPLACE
這是拿來取代字元的 macro,特別是使用在重新命名的動作裡面。語法如下:
%replace ( l= , lv= , code= , key= , lsep=, osep=)變數解釋:
。l= 輸入字串
。lv= 取代上列字串的字串(可省略不用)
。code= 包含 key 所代表的符號變數的字串,通常是在程式中不會被變動的字串
。key= 用來當作取代「l」代表的字串的符號變數,預設值是 #
。lsep= 用來區隔輸入字串的字元,預設值是空白(%str())
。osep= 用來區隔輸出字串的字元,預設值是空白(%str())
舉例來說,如果在套入一組資料時要順便改變某些變數名稱,則程式碼為:
data ww;
 set w(rename=(x=__x y=__y z=__z);
run;
則可使用 %replace 來簡化:
data ww;
 set w(rename=(%replace(l=x y z, code=#=__#));
run;
這個程式會先把 l 所定義的 x y z 用依序一個 # 來取代,而 code 的作用就是把 x y z 一一套入「#=__#」的框架裡面,進而產生「x=__x y=__y z=__z」這三個字串出來。
另外還有更進階的寫法,就是把 %replace 放進另一個自創的 %rename 裡面,程式如下:
%macro rename ( list, pref=__) ;
%replace ( l=&list, code = # = &pref# )
%mend rename ;
%rename 的第一個參數就等於 %replace 的第一個參數,而 pref 就等於輸出字串裡面共有的字串(此例預設值是「__」)。因此原來的程式可以更簡化為:
data ww;
 set w(rename=(%rename(x y z)));
run;
這時「x y z」就等於「list」,也等於「l」,而 pref 所表示的「__」被丟進 %replace 的 code 參數裡面,則 code 就變成「code= #=__#」,這就便回原來只用 %replace 的那個程式碼了。
%replace 也可以使用在變數轉換上面。比方說上面這個例子,在 rename 後要把新變數轉換成 best 32. 的格式。如果不用額外的 macro 則語法是:
data ww;
  set w(rename=(%rename(x y z)));
 x=input(__x, best32.);
 y=input(__y, best32.);
 z=input(__z, best32.);
run;
同樣地,我們可以另外自製一個命為 %CHAR2NUM 的 macro,然後套用 %replace 去寫。方法如下:
%macro char2num ( list , pref = __ ) ;
%replace ( l=&list
, code= %str(# = input(&pref#,best32.);)
)
%mend char2num ;
這個新 macro 的參數用法和 %rename 一樣,但我們來看看 %replace 在裡面發會什麼功用。l 去呼叫 list 所定義的字串,而 code 生出「#=input(&pref#,best32.);」,其中 # 就是暫時替代 l/list 參數所定義的字串,pref 是利用預設值「__」,則 code 其實就是產生下面這三行:
x=input(__x, best32.);
y=input(__y, best32.);
z=input(__z, best32.);
因此原本的程式可以改寫成:
data ww;
   set w(rename=(%rename(x y z)));
 %char2num(x y z);
run;
。QT
這個 macro 只是很簡單地幫每個字元加上雙引號。語法如下:
%qt ( l=, lv= , lsep= %str( ), qt = %str(%"), osep=%str( ) )變數解釋:
。l= 輸入字串
。lv= 取代上列字串的字串(可省略不用)
。lsep= 用來區隔輸入字串的字元,預設值是空白(%str())
。qt= 幫每個字元左右加上的符號,預設值是雙引號(")
。osep= 用來區隔輸出字串的字元,預設值是空白(%str())
因此,如果要生成出「"a" "b" "c"」只需要簡單地使用:
%qt(l=a b c);以下是各 macro 的原始碼:
。ZIP
%macro zip
( l1= /* first list */
, lv1= /* external variable override for first list */
, sep1=%str( ) /* separator between the joined elements */
, l2= /* second list */
, lv2= /* external variable override for second list */
, sep2=%str( ) /* separator between the joined elements */
, osep=%str( ) /* separator between new elements */
) ;
/* %zip ( l1= a b , l2= c d ) produces ac bd
so does
%let list1 = a b ;
%let list2 = c d ;
%zip (lv1=list1, lv2=list2)
If lists do not have same length shorter length used and
warning to the log. Empty lists result in empty list and
no message.
If the LV options are used then L1, L2, and ZIP_: should be
avoided for variable names.
*/
%local zip_i zip_1 zip_2 zip_list ;
%if %length(&lv1) = 0 %then
%let lv1 = l1 ;
%if %length(&lv2) = 0 %then
%let lv2 = l2 ;
%do zip_i = 1 %to &sysmaxlong ;
%let zip_1 = %qscan(%superq(&lv1) , &zip_i, &sep1 ) ;
%let zip_2 = %qscan(%superq(&lv2) , &zip_i, &sep2 ) ;
%if %length(&zip_1) = 0 or %length(&zip_2) = 0 %then
%goto check ;
%if &zip_i = 1 %then
%let zip_list = &zip_1&zip_2 ;
%else
%let zip_list = &zip_list&osep&zip_1&zip_2 ;
%end ;
%check:
%if %length(&zip_1) > 0 or %length(&zip_2) > 0 %then
%put WARNING: Macro ZIP - list lengths do not match - shorter used. ;
%unquote(&zip_list)
%mend zip ;
。XPROD
%macro xprod
( l1= /* first list */
, lv1= /* external variable override for first list */
, sep1=%str( ) /* separator between elements of first list */
, l2= /* second list */
, lv2= /* external variable override for second list */
, sep2=%str( ) /* separator between elements of second list */
, osep=%str( ) /* separator between elements of new list */
) ;
%local xp_i xp_j xp_1 xp_2 xp_list ;
%if %length(&lv1) = 0 %then
%let lv1 = l1 ;
%if %length(&lv2) = 0 %then
%let lv2 = l2 ;
%do xp_i = 1 %to &sysmaxlong ;
%let xp_1 = %qscan(%superq(&lv1), &xp_i, &sep1) ;
%if %length(&xp_1) = 0 %then %goto endloop1 ;
%do xp_j = 1 %to &sysmaxlong ;
%let xp_2 = %qscan(%superq(&lv2), &xp_j, &sep2) ;
%if %length(&xp_2) = 0 %then %goto endloop2 ;
%if &xp_i = 1 and &xp_j = 1 %then
%let xp_list = &xp_1&xp_2 ;
%else
%let xp_list = &xp_list&osep&xp_1&xp_2 ;
%end ;
%endloop2:
%end ;
%endloop1:
%unquote(&xp_list)
%mend xprod ;
%RANGE
%macro range /* second more efficient version due to Chang Chung */
( to=1 /* end integer value */
, from=1 /* starting integer value */
, step=1 /* increment integer */
, osep=%str( ) /* sparator between integers */
) ;
/*
return sequence of integers starting at &FROM going to &TO
in steps of &step
%range(to=5) produces 1 2 3 4 5
*/
%local rg_i ;
%do rg_i = &from %to &to %by &step ;
%if &rg_i = &from %then
%do;&rg_i%end ;
%else
%do;&osep&rg_i%end ;
%end ;
%mend range ;
。REPLACE
%macro replace
( l= /* value list */
, lv= /* external variable override for value list */
, lsep=%str( ) /* separator between values */
, code= /* block of code containing symbolic variable */
, key=# /* symbolic variable to replace (#abc# etc.) */
, osep=%str( ) /* separator between new elements */
/* may be %str(;) when code is statement */
/* if so remember to add closing semicolon */
) ;
%local rg_i rg_w rg_list ;
%if %length(&lv) = 0 %then
%let lv = l ;
%if %length(%superq(&lv)) = 0 /*or %index(%superq(code),&key) = 0*/ %then
%do ;
%let rg_list = %superq(code) ;
%goto mexit ;
%end ;
%do rg_i = 1 %to &sysmaxlong ;
%let rg_w = %qscan(%superq(&lv),&rg_i,&lsep) ;
%if %length(&rg_w) = 0 %then %goto mexit ;
%if &rg_i = 1 %then
%let rg_list = %sysfunc(tranwrd(%superq(code),&key,&rg_w)) ;
%else
%let rg_list =
&rg_list&osep%sysfunc(tranwrd(%superq(code),&key,&rg_w)) ;
%end ;
%mexit:
%unquote(&rg_list)
%mend replace ;
Contact information
Ian Whitlock
29 Lonsdale Lane
Kennett Square, PA 19348
Ian.Whitlock@comcast.net
2008年8月14日 星期四
Adding One Value to All Observations
原文載點:http://www.nesug.info/Proceedings/nesug07/cc/cc45.pdf
由於最近在工作上太多人問到這個問題,所以我特別找出這一篇文章來說明。在 SAS 裡面,要在每筆資料後面加上一個特定值,依據資料排列格式的不同,有許多種作法。有得很簡單,只需要在 data step 加上一行即可,有得很複雜,得動用到 merge statement 或 proc sql 才能解決。這一篇在 NESUG 2007 年發表的技術文件列出了一些解法可供參考。
本例使用這個樣本資料:
如果打算算出 EARNHR 的中間值,然後讓他變成一個獨立的變數放在原資料 temp 的最後面。最常使用的方法是先使用 PROC MEANS 把中間值的結果另存到新的資料檔裡面:
然後再用 merge 的方法放回原資料檔:
接下來要教兩個進階用法。由於第一個方法會生出一個無用的資料檔 MEDIANEARNHR,雖然他只是放在暫存檔,關掉 SAS 後就會消失。但使用 PROC SQL 就根本連這個檔都不會產生。方法如下:
本例改成放 EARNHR 的平均值 MEANEARNHR。先用 PROC SQL 把 AVEARNHR 算出來,放進一個叫做 MEANEARNHR 的巨集變數裡面,然後在把他命名成mean放進原來的資料內。這還有很多其他的用途。比方說如果想要挑出 EARNHR 小於平均值的樣本,則可以用這個 data step 來挑出:
挑出來的結果是:
第三種方法則是用 SYMPUT 函式來定義巨集變數。此例,先用 PROC MEANS 去計算 EARNHR 的中間值,並存在 add2 裡面。
然後開一個虛無的資料集「_null_」(這個資料連在work library都不會出現),然後把 add2 裡面的中間值變數名稱用 SYMPUT 定義成巨集變數。
最後就可以利用這個巨集變數在新的 data step 裡面做很多動作。無論是新增變數還是去挑資料都相當容易。
個人傾向使用 PROC SQL 是因為他能夠減少無謂的資料檔輸出,只是需要相當熟悉他的語法才能夠用上手。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Anne W. Warren
MDRC
16 East 34th Street, 19th floor
New York, NY 10016
Work Phone: 212.340.8661
Fax: 212.684.0832
Email: anne.warren@mdrc.org
Web: www.mdrc.org
由於最近在工作上太多人問到這個問題,所以我特別找出這一篇文章來說明。在 SAS 裡面,要在每筆資料後面加上一個特定值,依據資料排列格式的不同,有許多種作法。有得很簡單,只需要在 data step 加上一行即可,有得很複雜,得動用到 merge statement 或 proc sql 才能解決。這一篇在 NESUG 2007 年發表的技術文件列出了一些解法可供參考。
本例使用這個樣本資料:
data temp;
input Obs ID EARNHR @@;
cards;
1 1 .
2 2 5.75
3 3 5.75
4 4 6.30
5 5 6.75
6 6 8.00
7 7 8.25
8 8 9.60
9 9 10.05
10 10 12.80
;
如果打算算出 EARNHR 的中間值,然後讓他變成一個獨立的變數放在原資料 temp 的最後面。最常使用的方法是先使用 PROC MEANS 把中間值的結果另存到新的資料檔裡面:
proc means data = temp noprint ;
  var EARNHR ;
  output out = add (drop = _TYPE_ _FREQ_) median(EARNHR) = MEDIANEARNHR;
run ;
然後再用 merge 的方法放回原資料檔:
data temp3 ;
  set temp ;
  if _N_ = 1 then set add ;
run ;
接下來要教兩個進階用法。由於第一個方法會生出一個無用的資料檔 MEDIANEARNHR,雖然他只是放在暫存檔,關掉 SAS 後就會消失。但使用 PROC SQL 就根本連這個檔都不會產生。方法如下:
proc sql ;
  select mean(EARNHR) as AVGEARNHR format = 8.2 into :MEANEARNHR
  from temp ;
quit;

data temp ;
  set temp ;
  mean= &MEANEARNHR ;
run ;
本例改成放 EARNHR 的平均值 MEANEARNHR。先用 PROC SQL 把 AVEARNHR 算出來,放進一個叫做 MEANEARNHR 的巨集變數裡面,然後在把他命名成mean放進原來的資料內。這還有很多其他的用途。比方說如果想要挑出 EARNHR 小於平均值的樣本,則可以用這個 data step 來挑出:
data temp2 ;
  set temp ;
  where EARNHR lt &MEANEARNHR ;
run ;
挑出來的結果是:
Obs ID EARNHR
1 2 5.75
2 3 5.75
3 4 6.30
4 5 6.75
5 6 8.00
第三種方法則是用 SYMPUT 函式來定義巨集變數。此例,先用 PROC MEANS 去計算 EARNHR 的中間值,並存在 add2 裡面。
proc means data = temp noprint ;
  var EARNHR ;
  output out = add2 (drop=_TYPE_ _FREQ_) median(EARNHR) = MEDIANEARNHR;
run ;
然後開一個虛無的資料集「_null_」(這個資料連在work library都不會出現),然後把 add2 裡面的中間值變數名稱用 SYMPUT 定義成巨集變數。
data _null_ ;
  set add2 ;
  call symputx ('MDNEARNHR', MEDIANEARNHR) ;
run ;
最後就可以利用這個巨集變數在新的 data step 裡面做很多動作。無論是新增變數還是去挑資料都相當容易。
data temp;
  set temp ;
  median=&MDNEARNHR;
  where EARNHR ge 0 and EARNHR lt &MDNEARNHR ;
run ;
個人傾向使用 PROC SQL 是因為他能夠減少無謂的資料檔輸出,只是需要相當熟悉他的語法才能夠用上手。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Anne W. Warren
MDRC
16 East 34th Street, 19th floor
New York, NY 10016
Work Phone: 212.340.8661
Fax: 212.684.0832
Email: anne.warren@mdrc.org
Web: www.mdrc.org
2008年4月30日 星期三
Adding One Value to All Observations
原文載點:http://www.nesug.info/Proceedings/nesug07/cc/cc45.pdf
這篇文件主要是在教如何將一個單一的值放進每一個觀測值裡面。文中一共使用四種方法,各種優缺點也一併討論。
首先整篇文章都是用下面這個資料 temp 當作範例。

[範例一]
如果要計算 EARNHR 的平均數,並順便把結果放在變成第四個變數 AVGEARNHR,則可以用下面這個程式完成:
這段 PROC SQL 首先是建立一個新的資料名為 temp1,並用 select * 選取 temp 裡面所有變數,之後馬上加上 mean(EARNHR) 來計算該變數的平均數,並把結果存在 AVGEARNHR 這個新變數裡面,其格式為數值 8.2。
列印 temp1 後的結果如下:

好處:簡單使用。
壞處:PROC SQL 所提供的函示很少,所以如果是要算一些奇怪的統計量而 PROC SQL 沒有內建的函示的話,這個方法就不適用了。
[範例二]
如果要讓程式在計算出 EARNHR 的平均數後做資料篩選,把 0<=EARNHR <= AVGEARNHR 的觀測值保留下來,則可以使用下面這個程式:
第一段 PROC SQL 只是單純地做計算平均數的動作,並把 AVGEARNHR 存成一個 macro 變數 MEANEARNHR,使其能夠直接使用於第二段的 data step 中。
列印 temp2 的結果如下:

好處:比使用 PROC MEANS 來算平均數然後再代入原始資料要來的快。
壞處:同範例一的壞處。
[範例三]
如果遇到 PROC SQL 函式庫裡所沒有的函式(如中位數),則需改用下面 PROC MEANS 來輔助。如下所示:
第一段的 PROC MEANS 就是拿來算 PROC SQL 所無法計算的中位數 MEDIANEARNHR,並另存於新的資料 add 裡面。然後在第二段的 data step 裡面用 if _N_=1 then set 的方法把 add 加入到 temp 裡面並另存新檔。
最後新資料 temp3 的結果變成:

好處:可解決 PROC SQL 無法提供特地函式的問題。
壞處:撰寫過程沒有如同 PROC SQL 那樣直覺。若不知 if _N_ = 1 then set 這個技巧的人就沒有辦法把算出來的值加進原始資料裡面。
[範例四]
此範例其實是結合範例二和範例三。程式如下:
第一段仍是用 PROC MEANS 來計算中位數。第二段則是用一個虛擬的資料 _null_(該資料不會出現在任何 library 裡面)把剛剛算出來的中位數用 Call SYMPUTX 存成一個 macro 變數 MEDIANEARNHR。最後第三段就可以直接使用這個 macro 變數去篩選資料。
結果如下:

好處:Call SYMPUTX 可以把任何要加入的數值變成 macro 變數,讓他能夠無論在任何階段都能使用。
壞處:同樣是不夠直覺。
補充:Call SYMPUTX 和 Call SYMPUT 的不同之處在於 Call SYMPUTX 可以直接把要轉成 macro 變數的原始變數內可能含有的空格完全刪除。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Anne W. Warren
MDRC
16 East 34th Street, 19th floor
New York, NY 10016
Work Phone: 212.340.8661
Fax: 212.684.0832
Email: anne.warren@mdrc.org
Web: www.mdrc.org
這篇文件主要是在教如何將一個單一的值放進每一個觀測值裡面。文中一共使用四種方法,各種優缺點也一併討論。
首先整篇文章都是用下面這個資料 temp 當作範例。
[範例一]
如果要計算 EARNHR 的平均數,並順便把結果放在變成第四個變數 AVGEARNHR,則可以用下面這個程式完成:
proc sql ;
    create table temp1 as
    select *,
                 mean(EARNHR) as AVGEARNHR format = 8.2
    from temp ;
quit;
這段 PROC SQL 首先是建立一個新的資料名為 temp1,並用 select * 選取 temp 裡面所有變數,之後馬上加上 mean(EARNHR) 來計算該變數的平均數,並把結果存在 AVGEARNHR 這個新變數裡面,其格式為數值 8.2。
列印 temp1 後的結果如下:
好處:簡單使用。
壞處:PROC SQL 所提供的函示很少,所以如果是要算一些奇怪的統計量而 PROC SQL 沒有內建的函示的話,這個方法就不適用了。
[範例二]
如果要讓程式在計算出 EARNHR 的平均數後做資料篩選,把 0<=EARNHR <= AVGEARNHR 的觀測值保留下來,則可以使用下面這個程式:
proc sql ;
    select
    mean(EARNHR) as AVGEARNHR format = 8.2 into :MEANEARNHR
    from temp ;
quit;

data temp2 ;
    set temp ;
    where EARNHR ge 0 and EARNHR lt &MEANEARNHR ;
run ;
第一段 PROC SQL 只是單純地做計算平均數的動作,並把 AVGEARNHR 存成一個 macro 變數 MEANEARNHR,使其能夠直接使用於第二段的 data step 中。
列印 temp2 的結果如下:
好處:比使用 PROC MEANS 來算平均數然後再代入原始資料要來的快。
壞處:同範例一的壞處。
[範例三]
如果遇到 PROC SQL 函式庫裡所沒有的函式(如中位數),則需改用下面 PROC MEANS 來輔助。如下所示:
proc means data = temp noprint ;
    var EARNHR ;
    output out = add (drop = _TYPE_ _FREQ_) median(EARNHR) = MEDIANEARNHR;
run ;

data temp3 ;
    if _N_ = 1 then set add ;
    set temp ;
run ;
第一段的 PROC MEANS 就是拿來算 PROC SQL 所無法計算的中位數 MEDIANEARNHR,並另存於新的資料 add 裡面。然後在第二段的 data step 裡面用 if _N_=1 then set 的方法把 add 加入到 temp 裡面並另存新檔。
最後新資料 temp3 的結果變成:
好處:可解決 PROC SQL 無法提供特地函式的問題。
壞處:撰寫過程沒有如同 PROC SQL 那樣直覺。若不知 if _N_ = 1 then set 這個技巧的人就沒有辦法把算出來的值加進原始資料裡面。
[範例四]
此範例其實是結合範例二和範例三。程式如下:
proc means data = temp noprint ;
    var EARNHR ;
    output out = add2 (drop=_TYPE_ _FREQ_) median(EARNHR) = MEDIANEARNHR;
run ;

data _null_ ;
    set add2 ;
    call symputx ('MDNEARNHR', MEDIANEARNHR) ;
run ;

data temp4 ;
    set temp ;
    where EARNHR ge 0 and EARNHR lt &MDNEARNHR ;
run ;
第一段仍是用 PROC MEANS 來計算中位數。第二段則是用一個虛擬的資料 _null_(該資料不會出現在任何 library 裡面)把剛剛算出來的中位數用 Call SYMPUTX 存成一個 macro 變數 MEDIANEARNHR。最後第三段就可以直接使用這個 macro 變數去篩選資料。
結果如下:
好處:Call SYMPUTX 可以把任何要加入的數值變成 macro 變數,讓他能夠無論在任何階段都能使用。
壞處:同樣是不夠直覺。
補充:Call SYMPUTX 和 Call SYMPUT 的不同之處在於 Call SYMPUTX 可以直接把要轉成 macro 變數的原始變數內可能含有的空格完全刪除。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Anne W. Warren
MDRC
16 East 34th Street, 19th floor
New York, NY 10016
Work Phone: 212.340.8661
Fax: 212.684.0832
Email: anne.warren@mdrc.org
Web: www.mdrc.org
2008年1月14日 星期一
Automatically Renaming Common Variables Before Merging
原文載點:http://www.nesug.info/Proceedings/nesug07/cc/cc06.pdf
在 merge 不同的資料集之前,如果有些變數名稱相同時會導致 merge 失敗。處理這種問題的方法不外乎是先把重複的變數名稱重新命名。rename 是 SAS data step 裡面用來重新替變數命名的基本語法,可是一旦重複的變數太多,用 rename 一個個輸入新變數名稱就會變的冗長耗時。Christopher J. Bost 在 NESUG 2007 提供了一種用 PROC SQL 快速大量自動重新命名的方法,在此提供給大家一個參考。
簡單地來看一個例子。假設下面兩個資料集準備要拿來合併:
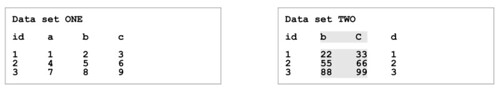
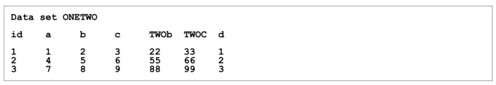
在這兩個不同的資料集裡面,變數 b 和 c 具有重複的變數名稱。因此在使用 merge 合併時,我們通常都會用下面這段程式碼替其中一邊的 b 和 c 重新命名:
結果如下:
可是,如果有幾十個,甚至幾百個變數都需要 rename 的話,那就必須得一一輸入 oldname = newname 這段程序。雖然在技術上不是什麼太大的問題,只要你有時間,一定是可以慢慢輸入完的。不過如果有更快速的方法能夠把 rename 這個動作用極短的程式碼來完成,而且還不需要另外呼叫其他 macro 來處理的話,那就更好了。
PROC SQL 程序可以取得一些 SAS 內部的訊息。這些訊息當然不是擺著好看的,可是懂得利用這些訊息的人並不多。所有變數和資料集的訊息,都會放在一個叫做 DICTIONARY.COLUMNS 的物件裡面。想要知道裡面有什麼訊息,可以用這段程式碼呼叫出來:
結果不是在 output,而是在 log 視窗裡面:
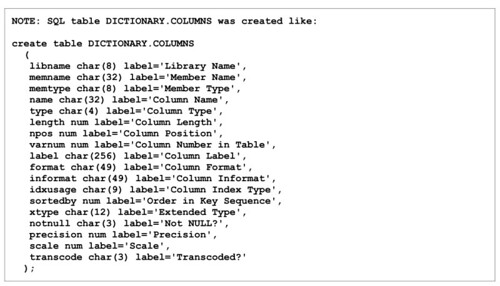
其中有三個訊息是可以拿來做重新命名的,分別是 libname、memname 和 name。如果想要知道這三個東西的詳細資訊,則可以用下面這段程式碼叫出:
結果如下:
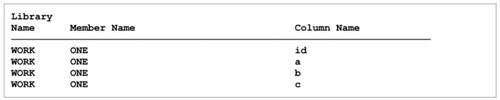
這段程式碼把資料集 one 和所在的 libary、資料集檔名以及內部變數名稱都列舉出來。特別注意一點是,library 和 memname 裡面的資訊都一概大寫,所以在 where statement 後面的 libname= 和 memname= 都要接上大寫的 library name 和 data set name,即便是這些原先都是小寫,還是得改成全部大寫。
如果只想知道變數訊息,則程式碼得改成:
由於 name 裡面的變數名稱大小寫會符合原始資料裡面的設定,但是 PROC SQL 在這部分只認得大寫,所以必須使用 upcase(name) 把裡面的資訊全部變成大寫,然後再把小寫的 id 變成大寫的 ID。如果單獨用 PROC SQL 跑這段程式,輸出結果如下所示:
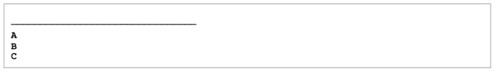
接著,針對資料集 two,我們也只想知道其變數資訊,則可用下面這段程式碼:
其中 previous query 上指上一段叫出資料集 one 變數訊息的程式碼。如果單獨跑這段程式,輸出結果如下所示:
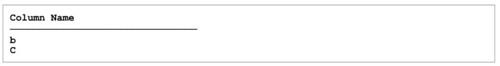
最後,重新命名的動作就交給下面這段程式碼:
這邊的 previous query 則是繼續把前兩段程式碼給複製進來。trim() 函示是把可能的空白給去掉。這個 select statement 會產生下面這種結果:
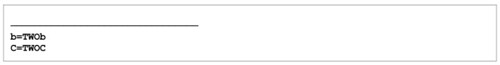
這個結果不就是 rename statement 後面要輸入的 oldname=newname 嗎?為了要把這段結果放進 data step 來自動重新命名,需要再多一行程式:
這行程式會把之前所有 oldname=newname 的結果放在 renamelist 這個巨集參數裡面,並且每一段都用一個空格區分開來(這就是 separated by ' ' 的目的)。結合上面的程式:
這段程式碼混在一起就會把「b=TWOb c=TWOc」這段程式碼放進 renamelist 裡面。雖然他看起來很複雜,但根據不同的情況只需要改兩個地方即可:
1. 第一個 select statement 後面的 TWO 可以改成自己想要重新命名的變數名稱開頭。
2. 最後一個 where statement 後面的 ID 改成你自己要合併資料集所使用的合併準則。此例是 merge by id,所以這邊就要用 ID。如果你是 merge by subject,則此處就改成 SUBJECT。
然後使用下面這段程式碼把 renamelist 設定成巨集變數:
最後只要在一開始的 data step 裡面做點小更改即可:
只要把 rename 後面可能的一長串 oldname=newname 換成 &renamelist 就大功告成了。結果如下所示:
當然,如果你覺得之前介紹的 text utility 裡面的 rename macro 很好用的話也可以使用他。
CONTACT INFORMATION
Christopher J. Bost
Director, Research Technology Unit
MDRC
16 East 34th Street, 19th Floor
New York, NY 10016
(212) 340-8613 telephone
(212) 684-0832 fax
christopher.bost@mdrc.org
www.mdrc.org
在 merge 不同的資料集之前,如果有些變數名稱相同時會導致 merge 失敗。處理這種問題的方法不外乎是先把重複的變數名稱重新命名。rename 是 SAS data step 裡面用來重新替變數命名的基本語法,可是一旦重複的變數太多,用 rename 一個個輸入新變數名稱就會變的冗長耗時。Christopher J. Bost 在 NESUG 2007 提供了一種用 PROC SQL 快速大量自動重新命名的方法,在此提供給大家一個參考。
簡單地來看一個例子。假設下面兩個資料集準備要拿來合併:
在這兩個不同的資料集裡面,變數 b 和 c 具有重複的變數名稱。因此在使用 merge 合併時,我們通常都會用下面這段程式碼替其中一邊的 b 和 c 重新命名:
data onetwo;
merge one two(rename=(b=TWOb C=TWOC));
by id;
run;
結果如下:
可是,如果有幾十個,甚至幾百個變數都需要 rename 的話,那就必須得一一輸入 oldname = newname 這段程序。雖然在技術上不是什麼太大的問題,只要你有時間,一定是可以慢慢輸入完的。不過如果有更快速的方法能夠把 rename 這個動作用極短的程式碼來完成,而且還不需要另外呼叫其他 macro 來處理的話,那就更好了。
PROC SQL 程序可以取得一些 SAS 內部的訊息。這些訊息當然不是擺著好看的,可是懂得利用這些訊息的人並不多。所有變數和資料集的訊息,都會放在一個叫做 DICTIONARY.COLUMNS 的物件裡面。想要知道裡面有什麼訊息,可以用這段程式碼呼叫出來:
proc sql;
describe table dictionary.columns;
quit;
結果不是在 output,而是在 log 視窗裡面:
其中有三個訊息是可以拿來做重新命名的,分別是 libname、memname 和 name。如果想要知道這三個東西的詳細資訊,則可以用下面這段程式碼叫出:
proc sql;
select libname, memname, name
from dictionary.columns
where libname='WORK' and memname='ONE';
quit;
結果如下:
這段程式碼把資料集 one 和所在的 libary、資料集檔名以及內部變數名稱都列舉出來。特別注意一點是,library 和 memname 裡面的資訊都一概大寫,所以在 where statement 後面的 libname= 和 memname= 都要接上大寫的 library name 和 data set name,即便是這些原先都是小寫,還是得改成全部大寫。
如果只想知道變數訊息,則程式碼得改成:
select upcase(name)
from dictionary.columns
where libname='WORK' and memname='ONE' and upcase(name) ne 'ID';
由於 name 裡面的變數名稱大小寫會符合原始資料裡面的設定,但是 PROC SQL 在這部分只認得大寫,所以必須使用 upcase(name) 把裡面的資訊全部變成大寫,然後再把小寫的 id 變成大寫的 ID。如果單獨用 PROC SQL 跑這段程式,輸出結果如下所示:
接著,針對資料集 two,我們也只想知道其變數資訊,則可用下面這段程式碼:
select name
from dictionary.columns
where libname='WORK' and memname='TWO' and upcase(name) in ( previous query )
其中 previous query 上指上一段叫出資料集 one 變數訊息的程式碼。如果單獨跑這段程式,輸出結果如下所示:
最後,重新命名的動作就交給下面這段程式碼:
select trim(name) || '=' || 'TWO' || name
from ( previous query )
這邊的 previous query 則是繼續把前兩段程式碼給複製進來。trim() 函示是把可能的空白給去掉。這個 select statement 會產生下面這種結果:
這個結果不就是 rename statement 後面要輸入的 oldname=newname 嗎?為了要把這段結果放進 data step 來自動重新命名,需要再多一行程式:
into :renamelist separated by ' '這行程式會把之前所有 oldname=newname 的結果放在 renamelist 這個巨集參數裡面,並且每一段都用一個空格區分開來(這就是 separated by ' ' 的目的)。結合上面的程式:
proc sql noprint;
select trim(name) || '=' || 'TWO' || name
into :renamelist separated by ' ' from
(select name
 from dictionary.columns
 where libname='WORK' and memname='TWO' and upcase(name) in
      (select upcase(name)
       from dictionary.columns
       where libname='WORK' and memname='ONE' and upcase(name) ne 'ID'));
quit;
這段程式碼混在一起就會把「b=TWOb c=TWOc」這段程式碼放進 renamelist 裡面。雖然他看起來很複雜,但根據不同的情況只需要改兩個地方即可:
1. 第一個 select statement 後面的 TWO 可以改成自己想要重新命名的變數名稱開頭。
2. 最後一個 where statement 後面的 ID 改成你自己要合併資料集所使用的合併準則。此例是 merge by id,所以這邊就要用 ID。如果你是 merge by subject,則此處就改成 SUBJECT。
然後使用下面這段程式碼把 renamelist 設定成巨集變數:
%put &renamelist;最後只要在一開始的 data step 裡面做點小更改即可:
data onetwo;
merge one two(rename=(&renamelist));
by id;
run;
只要把 rename 後面可能的一長串 oldname=newname 換成 &renamelist 就大功告成了。結果如下所示:
當然,如果你覺得之前介紹的 text utility 裡面的 rename macro 很好用的話也可以使用他。
CONTACT INFORMATION
Christopher J. Bost
Director, Research Technology Unit
MDRC
16 East 34th Street, 19th Floor
New York, NY 10016
(212) 340-8613 telephone
(212) 684-0832 fax
christopher.bost@mdrc.org
www.mdrc.org
2007年12月23日 星期日
The TRANPOSE Procedure or How to Turn It Around
 原文載點:http://www2.sas.com/proceedings/sugi31/234-31.pdf
資料轉置的工作,在 SAS 裡算是一門相當深奧的學問,也有許多不同的方法可以完成。PROC TRANSPOSE 是 SAS 內建的資料轉置程序,特別是將直的資料轉成橫的,更能顯現其威力。Janet Stuelpner 在 SUGI 31 中針對 PROC TRANSPOSE 程序做了一點概略的介紹,同時也剖析了一些使用上的變化,使用者可依照其不同的需求進行調整。
首先做點名詞解釋。所謂的直的資料(vertical data)長的是這個樣子:

而橫的資料(horizontal data)則是長的像這個樣子:

不過之後的範例所使用的資料是這個:

先用最簡單的程式來看結果會是什麼:
proc transpose data=vitals; run;
proc print; run;
這個 PROC TRANSPOSE 程序完全沒有呼叫任何 statement,則 SAS 會將整個資料以右上角為支點,像翻書一樣把資料往右上角做一百八十度的翻動。則結果會像下圖所示:

有上圖可見,經過轉置後,所有的變數被放在一個叫做 _NAME_ 的新變數底下。所有標籤則是被放在新變數 _LABEL_ 底下。至於轉置後的數據,SAS 則是自動從 COL1 開始命名直到最後。
如果想要針對這些新變數進行重新命名,可以直接從 PROC TRANSPOSE 程序來進行,不需要另外開一個 data step 來修改。程式如下所示:
proc transpose data=vitals label=DESC name=VAR prefix=VAL;
run;
這個程式多了三個 options。 label 即是用來替 _LABEL_ 重新命名,name 則是用來替 _NAME_ 從新命名,而 prefix 則是將 COL1 到 COL11 開頭的 COL 重新命名。
重新命名後的資料呈現如下圖:

如果需要針對一些類別變數內各層進行資料轉置,可使用 BY statement 來完成。範例程式如下:
proc transpose data=vitals label=DESC name=VAR prefix=VAL;
by protocol inv pat;
run;
此程式一次把三個類別變數 protocol、inv 和 pat 放進 BY statement 裡,則 SAS 會先對這三個變數排序歸類,然後再依照不同的層級進行資料轉置。結果如下圖:

也可以針對特地變數使用 VAR statement 進行轉置:
proc transpose data=student  out=s1  prefix=info;
by name;
var class grade credit;
run;
結果如下:

不過不建議這種轉法,尤其當變數屬性不同時,因為這樣很容易造成轉置後的新變數屬性產生混亂。
如果想要替轉置後的新變數用比較有意義的方式重新命名,而非使用 prefix 做單純但無意義的命名,則可以使用 ID statement 來完成這項工作。此處使用一個新的資料:
data student;
input name $1-10 class $12-18 grade $20 @@;
cards;
Ann Adams  CHEM101 A
Ann Adams  MATH101 A
Ann Adams  LIT100  B
Ann Adams  PHY101  A
Ann Adams  FREN100 B
Ann Adams  LAB     B
Ann Adams  SPAN200 .
Bob Benz   CHEM101 B
Bob Benz   MATH101 A
Bob Benz   LIT100  A
Bob Benz   PHY101  C
Bob Benz   FREN100 B
Bob Benz   LAB     B
Bob Benz   SPAN200 C
Carl Jones CHEM101 B
Carl Jones MATH101 .
Carl Jones LIT100  A
Carl Jones PHY101  C
Carl Jones FREN100 C
Carl Jones LAB     A
Carl Jones SPAN200 .
run;
程式如下:
proc transpose data=student;
by name;
var grade;
id class;
run;
結果如下:

明顯的可以發現,SAS 自動地將原本 ID statement 底下的 class 變數變成了轉置後新變數的名稱了。
AUTHOR CONTACT
Janet Stuelpner
Left Hand Computing, Inc
326 Old Norwalk Road
New Canaan, CT 06840
(203) 966-7520 voice
(203) 966-8027 fax
jstuelpner@usa.net
2007年5月3日 星期四
An Introduction to Reshaping (TRANSPOSE) and Combining (MATCH-MERGE) SAS Data Sets
原文載點:http://www.nesug.info/Proceedings/nesug06/hw/hw09.pdf
SAS 強大的資料管理功能大概是無庸置疑的,但困難的語法以及邏輯觀念的需求則是許多普通使用者沒有辦法在短時間內理解的,尤其是在資料轉置或合併的時候。Mike Zdeb 在 2006 年的 NESUG 發表了一篇技術文件,提供多種範本讓大家輕鬆轉置或合併檔案。
轉置:橫變直
假設原始資料是個重複觀測資料,但資料型態卻是每個重複的觀測值自存成一個新的變數,如下所示:
要將這類橫向紀錄的資料轉成直向記錄的資料,可以用 PROC TRANSPOSE 輕鬆達成:
其中:

如果想要和一般的矩陣轉置一樣,讓行變成列,列變成行,可以用下面的程式來達成:
則資料會變成:

轉置:直變橫
假設資料型態是每個觀測值有兩個變數,並且重複測量多次,資料輸入程式為:
會長的像這個樣子:

我們可用 PROC TRANSPOSE 一次同時轉兩個變數:
則資料會轉成這個型態:

如果只要轉 deposit 這個變數,程式如下:
資料變成這個的樣子:

如果想要把上面的變數名稱改成 month,首先需先將原始資料中的 month 改成文字型態:

在 PROC TRANSPOSE 中,用 id 就可以把 中代入的變數轉換成轉置後的變數名稱:
從下圖可見 month 的紀錄都變成了轉置後的變數名稱:

其他轉置方法
高階使用者可能不屑用 PROC TRANSPOSE 這個簡單的玩意兒,而是直接在 data step 的階段進行轉置。以第一個例子來說,可以用下面的程式來完成:
若是第二個例子,則程式比較複雜:
其實簡單來說,都是在玩弄陣列(array)的技巧。但我仍推薦 PROC TRANSPOSE 來轉置資料。用 data step 來玩轉置的唯一好處是可以同時進行其他變數變換的動作,而 PROC TRANSPOSE 就只是單純在做變數轉置而已。
合併資料
接下來用兩筆資料來討論一些合併資料的程式:

資料輸入程式:
最簡單的合併,就是跟去 snn 將 weight 和 zip 合併起來:
合併後的資料:

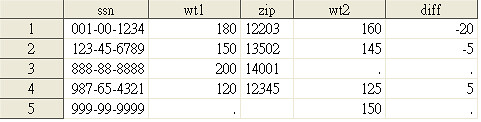
眼尖的人可以發現,資料 Jan 的 zip 是合併到 資料 Feb 裡面了,但是 weight 仍舊沒有合併過去。因此,我們可以在合併的過程中,直接更改兩個 weight 變數的名字,這樣 Jan 的 weight 就會順利合併過去,另一個好處是可以順便做一些簡單的資料運算。如下列程式所示:
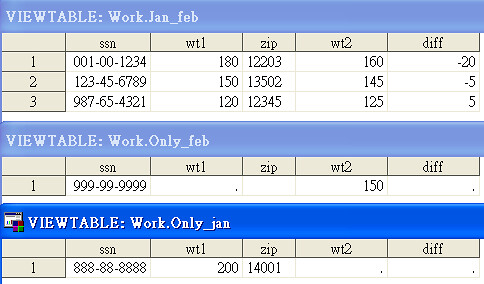
上面的程式就是在合併的過程中將資料 Jan 的 weight 改名為 wt1,資料 Feb 的 weight 改名為 wt2。接著,令兩者相減,造出一個新的變數名為 diff。結果如下所示:
接下來示範一個高階技巧,不但可以像上面的程式一樣,同時進行改名、合併和變數運算的工作,還可以將不同情況的變數存進不同的資料檔裡面:
這裡用到一個特殊技巧就是「in=」的應用。他會製造一個隱形的變數(如範例中的 j 和 f),當觀測值或變數是在資料 Jan 時,則 j=1,反之 j=0。同理,當觀測值或變數是在資料 Feb 時,則 f=1,反之則 f=0。程式中利用 if ... then ... else ... 的語法,讓 j=k=1 的觀測值存入新資料 jan_feb 中,如果只有 j=1 則存入 only_jan 中,如果只有 k=1 則存入 only_feb 中。因此,一個 data step 可以一次產生三個檔案:
merge 語法經常出現一個問題。如果兩個資料的觀測值都是一對一,那合併起來自然沒啥問題,但如果某個觀測值在兩個資料裡面的個數是不等的,如下所示:
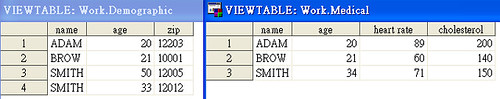
則合併起來會出現很詭異的情況:

上圖中,有沒有發現,當名字是 SMITH 時,age=50的那筆資料被 age=34 蓋掉了。Mike Zdeb 在文內並沒有提到解決的方法,只有提醒使用者注意。如果不想讓第一個資料檔裡面的觀測值被第二個資料檔裡面的觀測值覆蓋的話,可以用下面的程式解決:
這個道理就是讓 name 和 age 兩個變數都丟入 merge 合併的依據準則內,這樣一來兩個變數就不會產生覆蓋的情況。不過要 merge 前一定要先對這兩個變數做 PROC SORT。執行程式後會得到:

其他還有一些進階使用 RPOC SQL 的語法,熟悉 PROC SQL 的人可以詳讀原文。在此不做敘述。
CONTACT INFORMATION
The author can be contacted using e-mail... msz03@albany.edu
SAS 強大的資料管理功能大概是無庸置疑的,但困難的語法以及邏輯觀念的需求則是許多普通使用者沒有辦法在短時間內理解的,尤其是在資料轉置或合併的時候。Mike Zdeb 在 2006 年的 NESUG 發表了一篇技術文件,提供多種範本讓大家輕鬆轉置或合併檔案。
轉置:橫變直
假設原始資料是個重複觀測資料,但資料型態卻是每個重複的觀測值自存成一個新的變數,如下所示:
data many_dx;
infile datalines missover;
input id : $2. (dx1-dx5)(:$3.);
datalines;
01 647 641 650 428
02 428 416
03 642 674 648
04 641 416 648 647 641
;
run;
要將這類橫向紀錄的資料轉成直向記錄的資料,可以用 PROC TRANSPOSE 輕鬆達成:
proc transpose data=many_dx out=all_dx;
var dx1-dx5;
by id;
run;
其中:
- data = 要轉置的檔
- out = 轉置後輸出的檔
- var = 要轉置的變數
- by = 根據哪個變數來依序轉置
如果想要和一般的矩陣轉置一樣,讓行變成列,列變成行,可以用下面的程式來達成:
data many_dx;
infile datalines missover;
input id dx1-dx5;
datalines;
01 647 641 650 428
02 428 416
03 642 674 648
04 641 416 648 647 641
;
run;

proc transpose data=many_dx out=all_dx;
run;
則資料會變成:
轉置:直變橫
假設資料型態是每個觀測值有兩個變數,並且重複測量多次,資料輸入程式為:
data deposits;
input account : $2. month deposit @@;
datalines;
01 1 100 01 4 50 01 6 200
02 2 50 02 3 100
03 1 50 03 2 50 03 3 50 03 4 50 03 5 50 03 6 50
;
run;
會長的像這個樣子:
我們可用 PROC TRANSPOSE 一次同時轉兩個變數:
proc transpose data=deposits out=acct_deposits;
by account;
run;
則資料會轉成這個型態:
如果只要轉 deposit 這個變數,程式如下:
proc transpose data=deposits out=acct_deposits;
var deposit;
by account;
run;
資料變成這個的樣子:
如果想要把上面的變數名稱改成 month,首先需先將原始資料中的 month 改成文字型態:
data deposits;
input account : $2. month : $3. deposit @@;
datalines;
01 JAN 100 01 APR 50 01 JUN 200
02 FEB 50 02 MAR 100
03 JAN 50 03 FEB 50 03 MAR 50 03 APR 50 03 MAY 50 03 JUN 50
;
run;
在 PROC TRANSPOSE 中,用 id
proc transpose data=deposits out=acct_deposits (drop=_name_);
var deposit;
by account;
id month;
run;
從下圖可見 month 的紀錄都變成了轉置後的變數名稱:
其他轉置方法
高階使用者可能不屑用 PROC TRANSPOSE 這個簡單的玩意兒,而是直接在 data step 的階段進行轉置。以第一個例子來說,可以用下面的程式來完成:
data all_dx;
set many_dx;
array dx(5);
do j=1 to 5;
diag=dx(j);
if diag ne ' ' then output;
end;
keep diag;
run;
若是第二個例子,則程式比較複雜:
data all_dx;
retain dep1-dep6;
set deposits;
by account;
array dep(6);
if first.account then do j=1 to 6;
dep(j) = .;
end;
dep(month) = deposit;
if last.account then output;
keep account dep1-dep6;
run;
其實簡單來說,都是在玩弄陣列(array)的技巧。但我仍推薦 PROC TRANSPOSE 來轉置資料。用 data step 來玩轉置的唯一好處是可以同時進行其他變數變換的動作,而 PROC TRANSPOSE 就只是單純在做變數轉置而已。
合併資料
接下來用兩筆資料來討論一些合併資料的程式:
data jan;
input ssn weight zip : $5.;
format ssn ssn.;
datalines;
001001234 180 12203 i
123456789 150 13502
888888888 200 14001
987654321 120 12345
;
run;
data feb;
input ssn weight;
format ssn ssn.;
datalines;
001001234 160 i
123456789 145
987654321 125
999999999 150
;
run;
最簡單的合併,就是跟去 snn 將 weight 和 zip 合併起來:
data jan_feb;
merge jan feb;
by ssn;
run;
合併後的資料:
data jan_feb;
merge jan (rename=(weight=wt1)) feb (rename=(weight=wt2));
by ssn;
diff = wt2 - wt1;
run;
上面的程式就是在合併的過程中將資料 Jan 的 weight 改名為 wt1,資料 Feb 的 weight 改名為 wt2。接著,令兩者相減,造出一個新的變數名為 diff。結果如下所示:
data jan_feb only_jan only_feb;
merge jan (in=j rename=(weight=wt1))
feb (in=f rename=(weight=wt2));
by ssn;
diff = wt2 - wt1;
if j and f then output jan_feb;
else if j then output only_jan;
else output only_feb;
run;
這裡用到一個特殊技巧就是「in=」的應用。他會製造一個隱形的變數(如範例中的 j 和 f),當觀測值或變數是在資料 Jan 時,則 j=1,反之 j=0。同理,當觀測值或變數是在資料 Feb 時,則 f=1,反之則 f=0。程式中利用 if ... then ... else ... 的語法,讓 j=k=1 的觀測值存入新資料 jan_feb 中,如果只有 j=1 則存入 only_jan 中,如果只有 k=1 則存入 only_feb 中。因此,一個 data step 可以一次產生三個檔案:
merge 語法經常出現一個問題。如果兩個資料的觀測值都是一對一,那合併起來自然沒啥問題,但如果某個觀測值在兩個資料裡面的個數是不等的,如下所示:
data demographic;
input name : $5. age zip : $5.;
datalines;
ADAMS 20 12203
BROWN 21 10001
SMITH 50 12005
SMITH 33 12012
;
run;
data medical;
input name : $5. age hr chol ;
label
hr = 'heart rate'
chol = 'cholesterol'
;
datalines;
ADAMS 20 89 200
BROWN 21 60 140
SMITH 34 71 150
;
run;
則合併起來會出現很詭異的情況:
data both;
merge demographic medical;
by name;
run;
上圖中,有沒有發現,當名字是 SMITH 時,age=50的那筆資料被 age=34 蓋掉了。Mike Zdeb 在文內並沒有提到解決的方法,只有提醒使用者注意。如果不想讓第一個資料檔裡面的觀測值被第二個資料檔裡面的觀測值覆蓋的話,可以用下面的程式解決:
proc sort data=demographic; by name age; run;
proc sort data=medical; by name age; run;
data both;
merge demographic medical;
by name age;
run;
這個道理就是讓 name 和 age 兩個變數都丟入 merge 合併的依據準則內,這樣一來兩個變數就不會產生覆蓋的情況。不過要 merge 前一定要先對這兩個變數做 PROC SORT。執行程式後會得到:
其他還有一些進階使用 RPOC SQL 的語法,熟悉 PROC SQL 的人可以詳讀原文。在此不做敘述。
CONTACT INFORMATION
The author can be contacted using e-mail... msz03@albany.edu
2007年4月26日 星期四
Storing and Using a List of Values in a Macro Variable
原文載點:http://www2.sas.com/proceedings/sugi30/028-30.pdf
之前曾經提過一個相當強大的 text utility macro 可以批次更改大量的變數名稱,但是在使用那個程式之前,我們必須先把舊的變數名稱用一個 %let 的函數先命個名起來,之後才能將舊變數一次代入 text utility macro。可是,當舊變數高達上百甚至上千個時,怎樣將舊變數一次代入 %let 函數就變成另一個問題。比較笨一點的方法,就是把資料轉成 EXCEL 檔,則第一行會變成變數名稱,再把他全部剪下來貼到 SAS 裡面。不過 Arthur L. Carpenter 在 2005 年的 SUGI 30 就發表了一個技術文件來說明如何迅速地一次使用一串變數。
首先,得把資料裡面所有變數的相關訊息,包含變數名稱、格式和長度存出來。
存出來後,就可以做下列很多事情:
BUILD THE LIST IN A DATA STEP
在一個 data step 中把 metaclass 裡面的變數名稱叫出來並命名為 allvars。
CREATING THE LIST WITH SQL
用 PROC SQL 把所有變數(包含名稱、長度、格式等訊息)一次叫出來,以供接下來的任何程序來使用。
上述程式中的 separated by 可以讓 SQL 一直加入接下來的東西,無論是變數名稱、格式或長度。如果只想抓出變數名稱,只要留下 varlist 相關的程式碼,其他諸如 typlist 和 lenlist 相關的程式碼都可以刪除。此外 cntlist 代表變數個數,其實這是巧妙的利用 &sqlobs 這個變數去自動計算的。
USING A MACRO LOOP
其實本文真正重點是這個 macro 程式碼。因為只要呼叫這個 macro,並且指定資料檔,電腦就可以自動幫你去抓該資料檔裡面所有的變數。裡面唯一要設定的變數 Dset 其實就是資料檔名稱。
COUNTING THE WORDS IN A LIST
這是另一個用來計算變數總數的 macro,雖然不知道其實用性,不過還是列出來。
一個簡短範例。執行上述 macro 後再輸入下列程式碼:
則 log 視窗會出現下面結果:
嗯~有點無聊,我覺得用 PROC CONTENTS 就可以知道變數總數了。= =
STEPPING THROUGH THE LIST USING THE %SCAN FUNCTION
這個 macro 主要是幫你產生一個新的資料夾,裡面有原來的變數(包含所有格式和長度),但是這個資料夾是空的,也就是說沒有任何觀測值在裡面。至於有什麼用呢?我也不知道,但總是有人會需要用到吧!裡面唯一的 macro 變數 dsn 是用來指定新的資料檔名稱。
上述 macro 執行出來的結果,其實就和下面這個普通的 data step 所產生出來的資料檔是一樣的。好處是,使用者就不用慢慢輸入那些煩人的變數名稱、格式和長度了。
AUTHOR CONTACT
Arthur L. Carpenter
California Occidental Consultants
P.O. Box 430
Oceanside, CA 92085-0430
(760) 945-0613
art@caloxy.com
www.caloxy.com
之前曾經提過一個相當強大的 text utility macro 可以批次更改大量的變數名稱,但是在使用那個程式之前,我們必須先把舊的變數名稱用一個 %let 的函數先命個名起來,之後才能將舊變數一次代入 text utility macro。可是,當舊變數高達上百甚至上千個時,怎樣將舊變數一次代入 %let 函數就變成另一個問題。比較笨一點的方法,就是把資料轉成 EXCEL 檔,則第一行會變成變數名稱,再把他全部剪下來貼到 SAS 裡面。不過 Arthur L. Carpenter 在 2005 年的 SUGI 30 就發表了一個技術文件來說明如何迅速地一次使用一串變數。
首先,得把資料裡面所有變數的相關訊息,包含變數名稱、格式和長度存出來。
proc contents data=sashelp.class noprint out=metaclass;
run;
存出來後,就可以做下列很多事情:
BUILD THE LIST IN A DATA STEP
在一個 data step 中把 metaclass 裡面的變數名稱叫出來並命名為 allvars。
%let varlist =;
data _null_;
set metaclass;
call symput('varlist',trim(resolve('&varlist'))||' '||trim(name));
run;
%put &varlist;
CREATING THE LIST WITH SQL
用 PROC SQL 把所有變數(包含名稱、長度、格式等訊息)一次叫出來,以供接下來的任何程序來使用。
proc sql noprint;
select name ,type, length
into :varlist separated by ' ',
:typlist separated by ' ',
:lenlist separated by ' '
from metaclass;
quit;
%let cntlist = &sqlobs;
%put &varlist;
%put &typlist;
%put &lenlist;
%put &cntlist;
上述程式中的 separated by 可以讓 SQL 一直加入接下來的東西,無論是變數名稱、格式或長度。如果只想抓出變數名稱,只要留下 varlist 相關的程式碼,其他諸如 typlist 和 lenlist 相關的程式碼都可以刪除。此外 cntlist 代表變數個數,其實這是巧妙的利用 &sqlobs 這個變數去自動計算的。
USING A MACRO LOOP
其實本文真正重點是這個 macro 程式碼。因為只要呼叫這個 macro,並且指定資料檔,電腦就可以自動幫你去抓該資料檔裡面所有的變數。裡面唯一要設定的變數 Dset 其實就是資料檔名稱。
%Macro GetVars(Dset) ;
%Local VarList ;
/* open dataset */
%Let FID = %SysFunc(Open(&Dset)) ;
/* If accessable, process contents of dataset */
%If &FID %Then %Do ;
%Do I=1 %To %SysFunc(ATTRN(&FID,NVARS)) ;
%Let VarList= &VarList %SysFunc(VarName(&amp;amp;FID,&I));
%End ;
/* close dataset when complete */
%Let FID = %SysFunc(Close(&FID)) ;
%End ;
&VarList
%Mend ;COUNTING THE WORDS IN A LIST
這是另一個用來計算變數總數的 macro,雖然不知道其實用性,不過還是列出來。
%macro wordcount(list);
%* Count the number of words in &LIST;
%local count;
%let count=0;
%do %while(%qscan(&list,&count+1,%str( )) ne %str());
%let count = %eval(&count+1);
%end;
&count
%mend wordcount;
一個簡短範例。執行上述 macro 後再輸入下列程式碼:
%put SASHELP.CLASS has %wordcount(&varlist) variables;則 log 視窗會出現下面結果:
86
87 %put SASHELP.CLASS has %wordcount(&varlist) variables;
SASHELP.CLASS has 5 variables
嗯~有點無聊,我覺得用 PROC CONTENTS 就可以知道變數總數了。= =
STEPPING THROUGH THE LIST USING THE %SCAN FUNCTION
這個 macro 主要是幫你產生一個新的資料夾,裡面有原來的變數(包含所有格式和長度),但是這個資料夾是空的,也就是說沒有任何觀測值在裡面。至於有什麼用呢?我也不知道,但總是有人會需要用到吧!裡面唯一的 macro 變數 dsn 是用來指定新的資料檔名稱。
%macro emptydsn(dsn);
data &dsn(keep=&varlist);
length
%do i = 1 %to &cntlist;
%scan(&varlist,&i) %if %scan(&typlist,&amp;amp;i)=2 %then $; %scan(&lenlist,&amp;amp;i)
%end;
;
stop;
run;
%mend emptydsn;
%emptydsn(dummyclass);上述 macro 執行出來的結果,其實就和下面這個普通的 data step 所產生出來的資料檔是一樣的。好處是,使用者就不用慢慢輸入那些煩人的變數名稱、格式和長度了。
data dummyclass(keep=Age Height Name Sex Weight);
length
Age 8
Height 8
Name $ 8
Sex $ 1
Weight 8
;
stop;
run;
AUTHOR CONTACT
Arthur L. Carpenter
California Occidental Consultants
P.O. Box 430
Oceanside, CA 92085-0430
(760) 945-0613
art@caloxy.com
www.caloxy.com
2007年3月18日 星期日
Data Entry Using SAS ®- A Discussion of Various Possibilities
原文載點:http://www2.sas.com/proceedings/sugi27/p224-27.pdf
當進行資料輸入時,最原始的方法就是用 Data step 的程式碼輸入變數名稱、標籤、屬性以及原始資料。但對於不熟悉這些設定和語法的使用者來說會造成很大的困擾。此外,純文字的資料輸入介面容易造成資料欄位錯誤的情況,一旦資料龐大,要找出錯位的地方會變得相當困難。所以很多使用者會利用 EXCEL 來輸入資料,再把資料導入 SAS 裡面。可是 EXCEL 並無法設定變數標籤和屬性,等導入 SAS 後,還是需要再一次用 data step 來重新設定。其實,SAS 裡面已經有一個資料輸入的視窗介面,雖然長的不是很好看,但是可以一次解決上述所說的問題。除此之外,還有其他利用 SAS 其他功能來輸入資料的方法,於是有人就在 SUGI 27 上面發表了一篇使用 SAS 資料輸入介面的教學文章。
裡面用了一個很小的資料來做教學範例資料集,如下所示:

VIEWTABLE
第一個方法也是最簡單的方法。
第一步驟,選擇工具列上的 Tools,再點選裡面的 Table Editor。

這時會看到一個類似 EXCEL 介面的視窗出現。

第二步驟,在 A 欄上點選滑鼠右鍵,接著選擇 Column Attributes。這個動作是拿來設定變數屬性。

然後就會看到一個變數屬性視窗介面。

第三步驟,在出現的變數屬性視窗裡面做下列的設定。

第四步驟,點選 Apply 按鈕進行確認。

第五步驟,在不關閉視窗的情況下,依序點選其他欄位繼續進行變數屬性設定。每設定好一個變數,記得按 Apply。

第六步驟,全部設定好之後,便可以關閉對話視窗。此時在資料輸入介面上面看到的欄位名稱是變數標籤,要顯示變數名稱,可選擇工具列上面的 View,再選擇 Column Names。

第七步驟,開始輸入資料。

第八步驟,點選工作列上的 File,然後點選 Save As 以儲存檔案。存好後就如下圖所示。

如果想要新增資料筆數,SAS 沒有辦法跟 EXCEL 一樣直接把資料填入,而必須先點選工具列上的 Edit,接著點選 Edit mode,再點選 Add Row 後才能繼續輸入。如下圖所示。


DATA CREATION AND DATA ENTRY USING THE ANALYST APPLICATION
這個方法是利用 SAS 內建的分析視窗(類似 SPSS 可以點選的介面)來輸入資料。
第一步驟,點選工具列上的 Solution → Analysis → Analyst。

第二步驟,點選 File → New。此時就會出現一個類似 EXCEL 的視窗,接著就可以直接輸入資料了。

和之前的 Viewtable 比較起來,這個方法最大的缺點就是沒有辦法設定變數屬性。這個缺點影響最大的地方在日期變數,因為他會把日期變數設定成字串變數。如果只是單純的數值變數和字串變數的話影響就會降低。好處是他可以任意的添加欄位,不用像 Viewtable 一樣要先進入 edit mode 才能重新編輯或新增資料。
DATA CREATION AND DATA ENTRY USING SAS/INSIGHT
這種方式是利用 SAS/INSIGHT 的功能來建立資料。
第一步驟,點選工具列上的 Solutions → Analysis → Interactive Data Analysis

第二步驟,點選 New 以建立新的資料集。

此時又會看到熟悉的類似 EXCEL 的介面,但是長的比 Viewtable 更醜了!

第三步驟,點選視窗最左上角的一個箭頭符號,會彈出一個小視窗,裡面有個 New Variable 選項,點下去!

第四步驟,會出現一個更醜的視窗,請輸入你要建立的變數個數。

以本文範例來說,輸入 7,然後按 OK,就會看到七個欄位在上面。

第五步驟,連點 A 欄兩次便可以開始定義變數屬性。

第六步驟,要設定變數格式,在工具列上選擇 Edit → Formats,若要設定日期變數,請再點選 Other。

這個方法和上兩個方法比較起來的唯一缺點是他並無法刪除已經輸入的欄位。可能需要經由 data step 才能做刪除欄位的動作。
USING THE FSEDIT PROCEDURE FOR DATA CREATION AND DATA ENTRY
最後一個方法是利用 PROC FSEDIT 的程序來呼叫出一個互動式視窗並完成資料輸入的動作。
第一步驟,輸入下列程式碼。
第二步驟,會出現下面這樣的視窗。可以輸入資料名稱、格式、長度、標籤。

第三步驟,開始輸入資料。

第四步驟,要輸入下一筆資料,得從工具列上選擇 Edit → Add New Record。

PROC FSEDIT 最大的缺點就是無法新增欄位。
無論上述哪一種方法,都可以讓使用者直接在 SAS 裡面建立資料集。如果要我推薦一個最好的方法,我推薦第一個 Viewtable。(因為我也只用過第一種方法。。。)
CONTACT INFORMATION
Ass. Prof. Dipl.Ing. Dr. Barbara Schneider
Institute for Medical Statistics
University of Vienna
Schwarzspanierstr. 17
A - 1090 Vienna
Austria
barbara.schneider@univie.ac.at
當進行資料輸入時,最原始的方法就是用 Data step 的程式碼輸入變數名稱、標籤、屬性以及原始資料。但對於不熟悉這些設定和語法的使用者來說會造成很大的困擾。此外,純文字的資料輸入介面容易造成資料欄位錯誤的情況,一旦資料龐大,要找出錯位的地方會變得相當困難。所以很多使用者會利用 EXCEL 來輸入資料,再把資料導入 SAS 裡面。可是 EXCEL 並無法設定變數標籤和屬性,等導入 SAS 後,還是需要再一次用 data step 來重新設定。其實,SAS 裡面已經有一個資料輸入的視窗介面,雖然長的不是很好看,但是可以一次解決上述所說的問題。除此之外,還有其他利用 SAS 其他功能來輸入資料的方法,於是有人就在 SUGI 27 上面發表了一篇使用 SAS 資料輸入介面的教學文章。
裡面用了一個很小的資料來做教學範例資料集,如下所示:
VIEWTABLE
第一個方法也是最簡單的方法。
第一步驟,選擇工具列上的 Tools,再點選裡面的 Table Editor。
這時會看到一個類似 EXCEL 介面的視窗出現。
第二步驟,在 A 欄上點選滑鼠右鍵,接著選擇 Column Attributes。這個動作是拿來設定變數屬性。
然後就會看到一個變數屬性視窗介面。
第三步驟,在出現的變數屬性視窗裡面做下列的設定。
第四步驟,點選 Apply 按鈕進行確認。
第五步驟,在不關閉視窗的情況下,依序點選其他欄位繼續進行變數屬性設定。每設定好一個變數,記得按 Apply。
第六步驟,全部設定好之後,便可以關閉對話視窗。此時在資料輸入介面上面看到的欄位名稱是變數標籤,要顯示變數名稱,可選擇工具列上面的 View,再選擇 Column Names。
第七步驟,開始輸入資料。
第八步驟,點選工作列上的 File,然後點選 Save As 以儲存檔案。存好後就如下圖所示。
如果想要新增資料筆數,SAS 沒有辦法跟 EXCEL 一樣直接把資料填入,而必須先點選工具列上的 Edit,接著點選 Edit mode,再點選 Add Row 後才能繼續輸入。如下圖所示。
DATA CREATION AND DATA ENTRY USING THE ANALYST APPLICATION
這個方法是利用 SAS 內建的分析視窗(類似 SPSS 可以點選的介面)來輸入資料。
第一步驟,點選工具列上的 Solution → Analysis → Analyst。
第二步驟,點選 File → New。此時就會出現一個類似 EXCEL 的視窗,接著就可以直接輸入資料了。
和之前的 Viewtable 比較起來,這個方法最大的缺點就是沒有辦法設定變數屬性。這個缺點影響最大的地方在日期變數,因為他會把日期變數設定成字串變數。如果只是單純的數值變數和字串變數的話影響就會降低。好處是他可以任意的添加欄位,不用像 Viewtable 一樣要先進入 edit mode 才能重新編輯或新增資料。
DATA CREATION AND DATA ENTRY USING SAS/INSIGHT
這種方式是利用 SAS/INSIGHT 的功能來建立資料。
第一步驟,點選工具列上的 Solutions → Analysis → Interactive Data Analysis
第二步驟,點選 New 以建立新的資料集。
此時又會看到熟悉的類似 EXCEL 的介面,但是長的比 Viewtable 更醜了!
第三步驟,點選視窗最左上角的一個箭頭符號,會彈出一個小視窗,裡面有個 New Variable 選項,點下去!
第四步驟,會出現一個更醜的視窗,請輸入你要建立的變數個數。
以本文範例來說,輸入 7,然後按 OK,就會看到七個欄位在上面。
第五步驟,連點 A 欄兩次便可以開始定義變數屬性。
第六步驟,要設定變數格式,在工具列上選擇 Edit → Formats,若要設定日期變數,請再點選 Other。
這個方法和上兩個方法比較起來的唯一缺點是他並無法刪除已經輸入的欄位。可能需要經由 data step 才能做刪除欄位的動作。
USING THE FSEDIT PROCEDURE FOR DATA CREATION AND DATA ENTRY
最後一個方法是利用 PROC FSEDIT 的程序來呼叫出一個互動式視窗並完成資料輸入的動作。
第一步驟,輸入下列程式碼。
proc fsedit new = SAS-data-set;
run;
第二步驟,會出現下面這樣的視窗。可以輸入資料名稱、格式、長度、標籤。
第三步驟,開始輸入資料。
第四步驟,要輸入下一筆資料,得從工具列上選擇 Edit → Add New Record。
PROC FSEDIT 最大的缺點就是無法新增欄位。
無論上述哪一種方法,都可以讓使用者直接在 SAS 裡面建立資料集。如果要我推薦一個最好的方法,我推薦第一個 Viewtable。(因為我也只用過第一種方法。。。)
CONTACT INFORMATION
Ass. Prof. Dipl.Ing. Dr. Barbara Schneider
Institute for Medical Statistics
University of Vienna
Schwarzspanierstr. 17
A - 1090 Vienna
Austria
barbara.schneider@univie.ac.at
訂閱:
文章 (Atom)