原文載點:http://www2.sas.com/proceedings/sugi29/189-29.pdf
在進行混合模型的估計中,模型檢定也是不可忽略的一個重要步驟,雖然 SAS 有現成的語法可以執行,但因為所產生的報表和圖型落落長,不熟悉的人根本不會知道哪些圖或報表是代表什麼意義。SAS 內部工作人員利用官方的資料和程式發表了一篇技術文件,詳盡地解說每一張圖表在混合模型檢定中的意義。
2012年3月24日 星期六


2012年3月13日 星期二
Count Data Models in SAS®
原文載點:[LINK]
在統計應用領域,我們經常會遇到所謂的"計數資料"(count data),比方說就診人數,死亡人數,顧客人數等等。在分析這些計數資料時,最常使用的模型莫過於卜瓦松模型(Poisson model)。但在實際的應用上,使用者經常需要面對兩大問題:一是過度離散(overdispersion)問題,二是觀測值有太多零(excess zeros)的問題。這些問題通常都會導致卜瓦松模型估計的結果有偏誤。因此 WenSui Liu 和 Jimmy Cela 在 2008 年 SAS Global Forum 發表了一篇技術文件,介紹一些其他比較適合處理計數資料的模型。
在統計應用領域,我們經常會遇到所謂的"計數資料"(count data),比方說就診人數,死亡人數,顧客人數等等。在分析這些計數資料時,最常使用的模型莫過於卜瓦松模型(Poisson model)。但在實際的應用上,使用者經常需要面對兩大問題:一是過度離散(overdispersion)問題,二是觀測值有太多零(excess zeros)的問題。這些問題通常都會導致卜瓦松模型估計的結果有偏誤。因此 WenSui Liu 和 Jimmy Cela 在 2008 年 SAS Global Forum 發表了一篇技術文件,介紹一些其他比較適合處理計數資料的模型。
2011年10月14日 星期五
Fitting Cox Model Using PROC PHREG and Beyond in SAS
http://support.sas.com/resources/papers/proceedings09/236-2009.pdf
Cox PH 模型在倖存分析(survival analysis)被廣泛的使用。一篇發表在SAS GLOBAL FORUM 2009的技術文件解說了在 SAS 底下如何用 Cox PH 模型來計算一些重要估計量的方法,並且提供一個方便的巨集程式來簡化繁複的程式寫作和運行。
Cox PH 模型在倖存分析(survival analysis)被廣泛的使用。一篇發表在SAS GLOBAL FORUM 2009的技術文件解說了在 SAS 底下如何用 Cox PH 模型來計算一些重要估計量的方法,並且提供一個方便的巨集程式來簡化繁複的程式寫作和運行。
2009年6月18日 星期四
Examining Mediator and Moderator effect using Rural Women HIV Study
原文載點:http://support.sas.com/resources/papers/proceedings09/191-2009.pdf
這一篇技術文件是簡單地利用一個真正的女性HIV資料來教如何使用 SAS 檢定 mediator(或稱 mediation) 和 moderator。關於 mediator 和 moderator 的定義請參照:
Mediator:http://davidakenny.net/cm/mediate.htm
Moderator:http://davidakenny.net/cm/moderation.htm
首先,這個資料背景是來自一個cross-sectional的長期研究裡面所抽出來的第一次面訪資料,總計有 280 位遭到 HIV 感染的女性。
這一篇技術文件是簡單地利用一個真正的女性HIV資料來教如何使用 SAS 檢定 mediator(或稱 mediation) 和 moderator。關於 mediator 和 moderator 的定義請參照:
Mediator:http://davidakenny.net/cm/mediate.htm
Moderator:http://davidakenny.net/cm/moderation.htm
首先,這個資料背景是來自一個cross-sectional的長期研究裡面所抽出來的第一次面訪資料,總計有 280 位遭到 HIV 感染的女性。
2008年4月30日 星期三
Using Macro and ODS to Overcome Limitations of SAS® Procedures
原文載點:http://www.nesug.info/Proceedings/nesug07/cc/cc26.pdf
在 SAS 中,只有 PROC REG、PROC LOGISTIC 和 PROC PHREG 具有 model selection 的功能,其餘諸如 PROC GENMOD、PROC CATMOD 或 PROC MIXED 都需要用「手動」的方式來挑選最佳模式。本文利用 ODS 的功能,提供一個 macro 程式讓 PROC GENMOD 可以進行自動的 model selection 動作,可大幅節省時間並且減少手動挑選模式的過程中所可能產生的錯誤。
首先必須先執行一個名叫 MdStmt 的 macro 將 PROC GENMOD 所產生的 Type 3 test 報表另存成一個新檔。程式如下:
此 macro 包含三個參數:
這程式包含四個參數:
不過這個 macro 有個缺陷(我自己發現的)。在 %MdStmt 中,ID 變數被固定為 S,而 covariance structure 的形式被固定成 cs。同理,model statement 後面的 option 也被固定為 dist=bin 和 link=logit,表示這個模式只能拿來做最簡單的 logistic regression model with binary response。因此,可以把 %MdStmt 改成:
然後 %MdSelect 改成:
這個調整過後的程式將可以更有彈性。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the authors at:
Jing Su
Merck & Co., Inc.
UG1D-88
Po Box 1000
North Wales, PA 19454-1099
Work Phone: 267-305-6949
Email: jing_su@merck.com
Wei (Lisa) Lin
Merck & Co., Inc.
UG1D-88
Po Box 1000
North Wales, PA 19454-1099
在 SAS 中,只有 PROC REG、PROC LOGISTIC 和 PROC PHREG 具有 model selection 的功能,其餘諸如 PROC GENMOD、PROC CATMOD 或 PROC MIXED 都需要用「手動」的方式來挑選最佳模式。本文利用 ODS 的功能,提供一個 macro 程式讓 PROC GENMOD 可以進行自動的 model selection 動作,可大幅節省時間並且減少手動挑選模式的過程中所可能產生的錯誤。
首先必須先執行一個名叫 MdStmt 的 macro 將 PROC GENMOD 所產生的 Type 3 test 報表另存成一個新檔。程式如下:
  %macro MdStmt(
    resvar =   /*response variable                                           */
   ,expvar =   /*list of explanatory variables, separated by ' '                 */
   ,clsvar =   /*classification variables in the CLASS statement separated by ' ' */
    );

   ods output Type3=pval(rename=source=parm);
   proc genmod data=indat descending;
class S &clsvar;
model &resvar= &expvar /dist=bin link=logit type3 lrci;
    repeated subject=S  /type=cs corrw covb;
    title "&resvar = &expvar";
   run;
   ods output close;
%mend MdStmt;
此 macro 包含三個參數:
- resvar:要放在 model statement 等號左邊的反應變數
- expvar:要放在 model statement 等號右邊的解釋變數
- clsvar:要放在 class statement 的類別變數
  %macro MdSelect(
    var=       /*response variable                               */
   ,intvar=   /*initial explanatory variables for full model       */
   ,catvar=   /*categorical explanatory variables                 */
   ,slstay=   /*criterion for removing variable                    */
    );

%let var=%upcase(&var);
%let intvar=%upcase(&intvar);
%let catvar=%upcase(&catvar);

%*-------------------------------------------------------------------------*;
%* Create empty dataset "step" with only one column "parm". It will be     *;
%* merged with "pval" from PROC GENMOD by "parm"                        *;
%*-------------------------------------------------------------------------*;
proc sql;
 create table step_&var (parm char(9));
quit;

  %let i=1;
  %do %until (&pmax<=&slstay);       %if &i = 1 %then             %MdStmt(resvar=&var ,expvar=&intvar, clsvar=&catvar); %*initial model;      %else %do;            %MdStmt(resvar=&var ,expvar=&varlist, clsvar=&catvar); %*reduced model;      %end;       proc sort data=step_&var; by parm;      proc sort data=pval; by parm;      data step_&var;            merge step_&var pval;            by parm;            p&i=put(ProbChiSq, pvalue6.3);            drop ProbChiSq ChiSq DF;      run;         proc sql noprint;            select max(ProbChiSq) into :pmax            from pval;             select distinct parm into  :varlist separated by ' '            from pval            having ProbChiSq^=max(ProbChiSq);      quit;       %let i=%eval(&i+1);          %end;     proc print data=step_&var;      title "&var: model selection process";    run;  %mend MdSelect;
這程式包含四個參數:
- var:要放在 model statement 等號左邊的反應變數
- intvar:要放在 model statement 等號右邊的解釋變數
- catvar:要放在 class statement 內的類別變數
- slstay:刪除變數的準則。這個值是要拿去跟 p-value 比的。通常是設定 0.1 或 0.5。
%MdSelect(var=Y1, intvar=C1 C2 C3 M1 M2 M3 M4 M5 M6 M7, catvar=C1 C2 C3, slstay=0.5);不過這個 macro 有個缺陷(我自己發現的)。在 %MdStmt 中,ID 變數被固定為 S,而 covariance structure 的形式被固定成 cs。同理,model statement 後面的 option 也被固定為 dist=bin 和 link=logit,表示這個模式只能拿來做最簡單的 logistic regression model with binary response。因此,可以把 %MdStmt 改成:
  %macro MdStmt(
   idvar=         /*ID variable*/
   ,resvar =   /*response variable                                           */
   ,expvar =   /*list of explanatory variables, separated by ' '                 */
   ,clsvar =   /*classification variables in the CLASS statement separated by ' ' */
   ,resdist=   /*distribution of response variable*/
   ,linkfunc=  /*link function*/
   ,covstr=          /*covariance structure type*/
    );

ods output Type3=pval(rename=source=parm);
proc genmod data=indat descending;
  class &idvar &clsvar;
  model &resvar= &expvar /dist=&resdist link=&linkfunc type3 lrci;
  repeated subject=&idvar  /type=&covstr corrw covb;
  title "&resvar = &expvar";
run;
ods output close;
%mend MdStmt;
然後 %MdSelect 改成:
  %macro MdSelect(
    id=     /*id variable*/
   ,var=       /*response variable                               */
   ,intvar=   /*initial explanatory variables for full model       */
   ,catvar=   /*categorical explanatory variables                 */
   ,slstay=   /*criterion for removing variable                    */
   ,dist=   /*distribution of response variable*/
   ,link=  /*link function*/
   ,type=          /*covariance structure type*/
    );

%let var=%upcase(&var);
%let intvar=%upcase(&intvar);
%let catvar=%upcase(&catvar);

%*-------------------------------------------------------------------------*;
%* Create empty dataset "step" with only one column "parm". It will be     *;
%* merged with "pval" from PROC GENMOD by "parm"                        *;
%*-------------------------------------------------------------------------*;
proc sql;
 create table step_&var (parm char(9));
quit;

  %let i=1;
  %do %until (&pmax<=&slstay);       %if &i = 1 %then             %MdStmt(idvar=&id, resvar=&var ,expvar=&intvar, clsvar=&catvar, resdist=&dist, linkfunc=&link, covstr=&cov); %*initial model;      %else %do;            %MdStmt(idvar=&id, resvar=&var ,expvar=&varlist, clsvar=&catvar, resdist=&dist, linkfunc=&link, covstr=&cov); %*reduced model;      %end;       proc sort data=step_&var; by parm;      proc sort data=pval; by parm;      data step_&var;            merge step_&var pval;            by parm;            p&i=put(ProbChiSq, pvalue6.3);            drop ProbChiSq ChiSq DF;      run;         proc sql noprint;            select max(ProbChiSq) into :pmax            from pval;             select distinct parm into  :varlist separated by ' '            from pval            having ProbChiSq^=max(ProbChiSq);      quit;       %let i=%eval(&i+1);          %end;     proc print data=step_&var;      title "&var: model selection process";    run;  %mend MdSelect;
這個調整過後的程式將可以更有彈性。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the authors at:
Jing Su
Merck & Co., Inc.
UG1D-88
Po Box 1000
North Wales, PA 19454-1099
Work Phone: 267-305-6949
Email: jing_su@merck.com
Wei (Lisa) Lin
Merck & Co., Inc.
UG1D-88
Po Box 1000
North Wales, PA 19454-1099
2007年10月3日 星期三
The Effect of Missing Data on Sample Sizes for Repeated Measures Models
原文載點:http://www2.sas.com/proceedings/sugi23/Stats/p231.pdf
在 mixed model 中,SAS 針對 missing data 的處理是一律先刪掉再去作分析。對使用者來說當然是一個相當方便的事情,但是就統計理論上,這種直接刪除 missing data 的動作其實潛在許多問題。比方說,如果一個資料庫裡面有十個預測變數,一個反應變數。如果其中有一個預測變數是 missing,或者只有反應變數是 missing,而其他預測變數是完整的,則整筆資料會因為少數的 missing data 而全數遭到刪除。無形間損失了許多其他存在的變數資訊,我們也應對如此的模式配適和分析結果感到懷疑。Maribeth Johnson 和 Pete Davis 在 SUGI 23 發表了一篇技術文件,專門來探討在不同的樣本大小和 missing rate 情況下,對 mixed model selection 挑選出來的 covariance structure 可能會有的影響。
Maribeth Johanson 和 Pete Davis 先是針對 Medical College of Georgia 所收集的一些重複測量的孩童血液收縮壓(systolic blood pressure,簡稱 SBP)的基本統計量和分析結果為基礎來先做資料模擬。這份原始數據顯示,孩童 SBP 的平均值是 110 mmHg,標準差是 10 mmHg。其次,根據 mixed model with TOEP covariance structure 的分析結果,四次重複測量的 correlation matrix 依序是 1, 0.7, 0.6 和 0.48。因此,模擬資料可經由下列多變量常態分配來模擬:
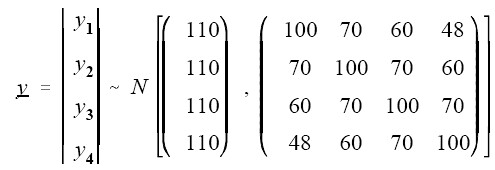
其中,x 可為隨機生成的亂數,其服從常態分配:

B 和 b 都是常數,其中 B 是 y 的 variance-covariance matrix 在 x 是獨立標準常態分配下經過 Cholesky decomposition 分解後產生的矩陣。想要用 SAS 做 Cholesky decomposition,可參考 SAS/IML 手冊。在本例中,經過分解後的 B 是:
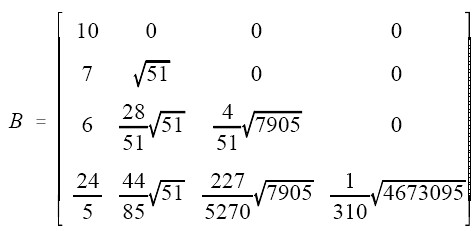
所以,y 可由下列公式模擬生成:
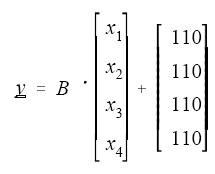
模擬程式如下:
第二個程式是可以將上述模擬結果挑出最佳化的 mixed model。其所使用的方法當然就是傳統的 likelihood ratio test(LRT):
這會讓前 60 筆資料成為 missing data,後 90 筆資料成為 complete data。由於一開始的原始數據是隨機生成的,所以經過刪除後剩下可以拿來配適 mixed model 的 90 筆數據仍舊是維持隨機。
以下列出四個表格表示不同的 missing rate 之下和不同的 sample size 之下所配適出來的 mixed model 中最好的 covariance structure 的分佈情況:
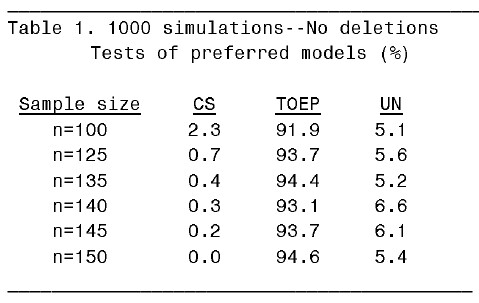
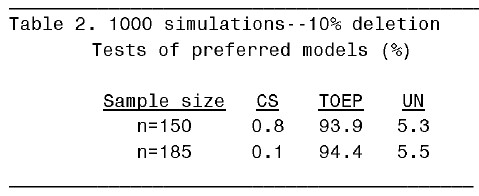
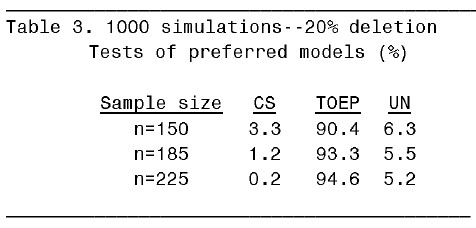
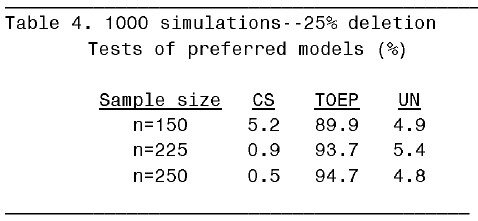
從 table 1 可知,當 n=150 時,1000 個資料集中會有 5.4% 的 UN mixed model,94.5% 的 TOEP mixed model。由於此處所設定的 Type I error 為 0.05,所以可以說在完整資料情況下,樣本數最好至少要有 150 才能有足夠的 power 讓模擬生成的數據所配適出來的 mixed model 符合原始數據所配適出來的 mixed model。在 10% missing rate 下,則樣本數要提高到 185。在 20% missing rate 下,樣本數要提高到 225。在 25% missing rate 下,樣本數得至少要 250 才行。
Author Contact
Maribeth Johnson
Office of Biostatistics, CI-104
Medical College of Georgia
Augusta, GA 30912-4900
Phone: (706) 721-3785
E-mail: maribeth@stat.mcg.edu
在 mixed model 中,SAS 針對 missing data 的處理是一律先刪掉再去作分析。對使用者來說當然是一個相當方便的事情,但是就統計理論上,這種直接刪除 missing data 的動作其實潛在許多問題。比方說,如果一個資料庫裡面有十個預測變數,一個反應變數。如果其中有一個預測變數是 missing,或者只有反應變數是 missing,而其他預測變數是完整的,則整筆資料會因為少數的 missing data 而全數遭到刪除。無形間損失了許多其他存在的變數資訊,我們也應對如此的模式配適和分析結果感到懷疑。Maribeth Johnson 和 Pete Davis 在 SUGI 23 發表了一篇技術文件,專門來探討在不同的樣本大小和 missing rate 情況下,對 mixed model selection 挑選出來的 covariance structure 可能會有的影響。
Maribeth Johanson 和 Pete Davis 先是針對 Medical College of Georgia 所收集的一些重複測量的孩童血液收縮壓(systolic blood pressure,簡稱 SBP)的基本統計量和分析結果為基礎來先做資料模擬。這份原始數據顯示,孩童 SBP 的平均值是 110 mmHg,標準差是 10 mmHg。其次,根據 mixed model with TOEP covariance structure 的分析結果,四次重複測量的 correlation matrix 依序是 1, 0.7, 0.6 和 0.48。因此,模擬資料可經由下列多變量常態分配來模擬:
其中,x 可為隨機生成的亂數,其服從常態分配:
B 和 b 都是常數,其中 B 是 y 的 variance-covariance matrix 在 x 是獨立標準常態分配下經過 Cholesky decomposition 分解後產生的矩陣。想要用 SAS 做 Cholesky decomposition,可參考 SAS/IML 手冊。在本例中,經過分解後的 B 是:
所以,y 可由下列公式模擬生成:
%global _PRINT_;
%let _PRINT_=OFF;

%macro simulate;
%do j=1 %to 1000;

data sbp;
  do i = 1 to 150;
     x1=rannor(647+i+&j*99);
     x2=rannor(372+i+&j*99);
     x3=rannor(425+i+&j*99);
     x4=rannor(162+i+&j*99);

     sbp1=10*x1+110;
     sbp2=7*x1+sqrt(51)*x2+110;
     sbp3=6*x1+(28/51)*sqrt(51)*x2+(4/51)*sqrt(7905)*x3+110;
     sbp4=(24/5)*x1+(44/85)*sqrt(51)*x2+(227/5270)*sqrt(7905)*x3+(1/310)*sqrt(4673095)*x4+110;
     output;
  end;
run;

data all;
  set sbp;
run;

proc transpose data=all out=allt;
  by i;
  var sbp1 sbp2 sbp3 sbp4;
run;

proc mixed data=allt;
  class _name_;
  model col1=_name_;
  repeated/type=un subject=i;
  make 'fitting' out=ftun&j;
run;
quit;

proc mixed data=allt;
  class _name_;
  model col1=_name_;
  repeated/type=toep subject=i;
  make 'fitting' out=fttp&j;
run;
quit;

proc mixed data=allt;
  class _name_;
  model col1=_name_;
  repeated/type=cs subject=i;
  make 'fitting' out=ftcs&j;
run;
quit;

data fit&j;
  merge ftcs&j(rename=(value=val_cs))
        fttp&j(rename=(value=val_toep))
        ftun&j(rename=(value=val_un));
  attrib simu length=$8;
  simu="Sim &j ";
output;

proc datasets;
  delete sbp all allt ftcs&j fttp&j ftun&j;
  append base=fit new=fit&j;
run;
%end;
%mend;第二個程式是可以將上述模擬結果挑出最佳化的 mixed model。其所使用的方法當然就是傳統的 likelihood ratio test(LRT):
data pref;
  set fit;
/*CS vs TOEP*/
  if descr="-2 Res Log Likelihood" and probchi((val_cs-val_toep),2) gt .95 then lrtc_t='TOEP';
     else if descr="-2 Res Log Likelihood" and probchi((val_cs-val_toep),2) le .95 then lrtc_t='CS  ';

/*TOEP vs UN*/
  if descr="-2 Res Log Likelihood" and probchi((val_toep-val_un),6) gt .95 then lrtt_u='UN  ';
     else if descr="-2 Res Log Likelihood" and probchi((val_toep-val_un),6) le .95 then lrtt_u='TOEP';
  title1 '1000 simulations--No deletions';
  title2 'Model fit information and tests of preferred models';
run;

proc print data=pref;
  id descr;
  where descr="-2 Res Log Likelihood";
run;

proc freq data=pref;
  tables lrtc_t*lrtt_u/list;
run;- 每個觀測值的第一年數據必須保留完整。
- missing data 散佈在第二年到第四年的數據。
- 每個觀測值最多只會有一個 missing datum。
if i le 20 then sbp2=.;
if i ge 21 and i le 40 then sbp3=.;
if i ge 41 and i le 60 then sbp4=.;
這會讓前 60 筆資料成為 missing data,後 90 筆資料成為 complete data。由於一開始的原始數據是隨機生成的,所以經過刪除後剩下可以拿來配適 mixed model 的 90 筆數據仍舊是維持隨機。
以下列出四個表格表示不同的 missing rate 之下和不同的 sample size 之下所配適出來的 mixed model 中最好的 covariance structure 的分佈情況:
從 table 1 可知,當 n=150 時,1000 個資料集中會有 5.4% 的 UN mixed model,94.5% 的 TOEP mixed model。由於此處所設定的 Type I error 為 0.05,所以可以說在完整資料情況下,樣本數最好至少要有 150 才能有足夠的 power 讓模擬生成的數據所配適出來的 mixed model 符合原始數據所配適出來的 mixed model。在 10% missing rate 下,則樣本數要提高到 185。在 20% missing rate 下,樣本數要提高到 225。在 25% missing rate 下,樣本數得至少要 250 才行。
Author Contact
Maribeth Johnson
Office of Biostatistics, CI-104
Medical College of Georgia
Augusta, GA 30912-4900
Phone: (706) 721-3785
E-mail: maribeth@stat.mcg.edu
2007年9月6日 星期四
Fitting Generalized Additive Models with the GAM Procedure
[註] 本文於 2008/01/05 修訂,主要是加強部分內文(紅字部分)的敘述。
原文載點:http://www2.sas.com/proceedings/sugi26/p256-26.pdf
Generalized additive model(簡稱GAM)在 1990 年由 Hastie & Tibshirani 發表出來後,就一直廣泛的被運用到許多領域中,如環境科學和醫學。GAM 的好處是沒有像其他線性模式一樣有很多的假設前提(如 normal assumption 或 variance homogeneity),而他在處理非線性模式的能力又比其他模型要來的強大。只要反應變數所服從的分配是指數族(exponential family)的一員,如 normal, binomial, Poisson, gamma 等,就可以使用 GAM。SAS 在 V8.2 版就已經納入了 PROC GAM 程序,讓使用者可以很輕鬆地用幾行指令輕易地配適出這個模型。Dong Xiang 在 SUGI 26 所發表的一篇簡單的 GAM 教學文件,讓初學者能夠在沒有足夠的背景知識下入門。
先簡單介紹一下 GAM 基本的概念。一般線性模式可如下所示:
E(Y)=b0+b1*X1+b2*X2+...+bp*Xp
但在 GAM 下,模式可改為:
E(Y)=s0+s1(X1)+s2(X2)+...+sp(Xp)
其中 si(Xi) 稱為 smooth function(或簡稱 smoother)。他們並沒有特別指定為某種方程式,而是以 non-parametric 的型態去估計。常用的估計方式稱為「backfitting algorithm」。由於 GAM 的 score equation 沒有 close form,所以必須依賴 backfitting algorithm 進行遞迴演算來估出 smoother 的參數。當然這個過程必須要交給電腦計算。
關於 smoother 的選擇有很多種,如 B-spline、thin-plate smoothing spline 或 LOESS 等等。使用者可以在 MODEL statement 直接呼叫想要的 smoother。不同的 smoother 有不同的呼叫語法,詳細情況可以上網查詢 PROC GAM 的 SAS 線上手冊。
每個 smoother 裡面會有一個參數,通常是自由度(df)。SAS 允許使用者自行決定 df ,也可以利用 GCV(generalized cross-validation)函數來挑選。
Xiang 引用了 Bell et al. 在 1989 年的一份有關駝背的醫學數據,其反應變數是一個二項變數(有(1)和無(0))。三個預測變數是 Age, StartVert 和 NumVert。資料如下所示:
先來看看報表長什麼樣子。首先第一張是 Summary Statistics,裡面提供一些資料和參數估計過程的訊息,不是很重要,可以不看。
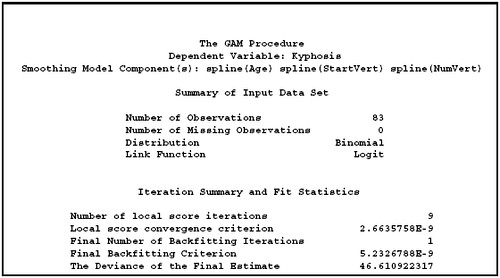
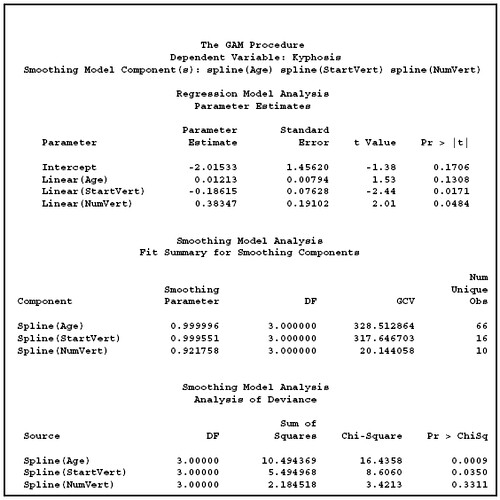
第二張才是重點。裡面包含三個報表。第一個報表表示當模式是用線性迴歸時所跑出的參數估計值。第二個報表是用 GAM 跑出的 smoother 參數估計值。第三個報表比較特別。此處利用 deviance analysis 來檢定比較 full model(包含全部 smoothing function)和 reduced model(少掉某一個 smoothing function)那個比較顯著。虛無假設則是 H0: reduce model vs H1: full model。如果後面的 p-value 小於 0.05 則表示拒絕 reduced model。反之則表示不拒絕 reduce model。以 Age 和 StartVert 來看,兩者的 p-value 分別是 0.0009 和 0.0350,皆小於 0.05。所以可以同時拒絕分別少了這兩個變數的 reduced model。而 NumVert 的 p-value 為 0.3311 > 0.05,表示不拒絕少了 NumVert 的 smoothing function 的 reduced model,亦即是說 f(NumVert) 在模式中是不顯著的。
之後可針對偏預測值(partial prediction)來做圖。偏預測值的定義是固定其餘的預測變數,來看某預測變數變動對反應變數的影響。由這些圖也可以看出預測變數的顯著性。如果預測變數的 95% 信賴區間完全涵蓋住 0 的話就表示該預測變數不顯著。
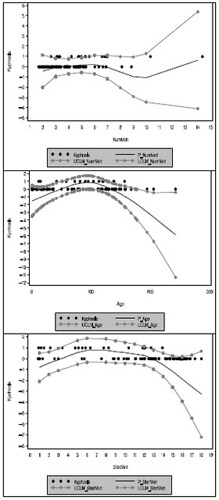
以第一張圖來看,NumVert 的 95% CI 完全包含 y=0,所以不顯著。Age(第二張圖)則是部分涵蓋,可視為顯著。比較有爭議的是 StartVert 的圖(第三張)。從圖形上來看,95% CI 應該算是完全包含了 y=0,可是末端有一小段相當逼近 y=0。原文並沒有特別說明這種情況該怎樣判斷,因此各位最好還是單純從 analysis of deviance 裡面的 p-value 來判斷,而不能完全應該偏預測值圖。此外,從 Age 和 StartVert 的偏預測值趨勢圖也可看出這兩個變數和反應變數有稍微二次項的關係。
PROC GAM 就是這麼簡單。不過,從 GAM 延伸出來的變形模式還有很多。有機會再來講 Bayesian analysis 搭配 GAM 的使用。
Contact Information
Dong Xiang, SAS Institute Inc., SAS Campus Drive,
Cary, NC 27513. Phone (919) 531-4854, FAX (919)
677-4444, Email dong.xiang@sas.com.
原文載點:http://www2.sas.com/proceedings/sugi26/p256-26.pdf
Generalized additive model(簡稱GAM)在 1990 年由 Hastie & Tibshirani 發表出來後,就一直廣泛的被運用到許多領域中,如環境科學和醫學。GAM 的好處是沒有像其他線性模式一樣有很多的假設前提(如 normal assumption 或 variance homogeneity),而他在處理非線性模式的能力又比其他模型要來的強大。只要反應變數所服從的分配是指數族(exponential family)的一員,如 normal, binomial, Poisson, gamma 等,就可以使用 GAM。SAS 在 V8.2 版就已經納入了 PROC GAM 程序,讓使用者可以很輕鬆地用幾行指令輕易地配適出這個模型。Dong Xiang 在 SUGI 26 所發表的一篇簡單的 GAM 教學文件,讓初學者能夠在沒有足夠的背景知識下入門。
先簡單介紹一下 GAM 基本的概念。一般線性模式可如下所示:
E(Y)=b0+b1*X1+b2*X2+...+bp*Xp
但在 GAM 下,模式可改為:
E(Y)=s0+s1(X1)+s2(X2)+...+sp(Xp)
其中 si(Xi) 稱為 smooth function(或簡稱 smoother)。他們並沒有特別指定為某種方程式,而是以 non-parametric 的型態去估計。常用的估計方式稱為「backfitting algorithm」。由於 GAM 的 score equation 沒有 close form,所以必須依賴 backfitting algorithm 進行遞迴演算來估出 smoother 的參數。當然這個過程必須要交給電腦計算。
關於 smoother 的選擇有很多種,如 B-spline、thin-plate smoothing spline 或 LOESS 等等。使用者可以在 MODEL statement 直接呼叫想要的 smoother。不同的 smoother 有不同的呼叫語法,詳細情況可以上網查詢 PROC GAM 的 SAS 線上手冊。
每個 smoother 裡面會有一個參數,通常是自由度(df)。SAS 允許使用者自行決定 df ,也可以利用 GCV(generalized cross-validation)函數來挑選。
Xiang 引用了 Bell et al. 在 1989 年的一份有關駝背的醫學數據,其反應變數是一個二項變數(有(1)和無(0))。三個預測變數是 Age, StartVert 和 NumVert。資料如下所示:
data kyphosis;
  input Age StartVert NumVert Kyphosis @@;
datalines;
71  5  3  0     158 14 3 0    128 5   4 1
2   1  5  0     1   15 4 0    1   16  2 0
61  17 2  0     37  16 3 0    113 16  2 0
59  12 6  1     82  14 5 1    148 16  3 0
18  2  5  0     1   12 4 0    243 8   8 0
168 18 3  0     1   16 3 0    78  15  6 0
175 13 5  0     80  16 5 0    27  9   4 0
22  16 2  0     105 5  6 1    96  12  3 1
131 3  2  0     15  2  7 1    9   13  5 0
12  2 14  1     8   6  3 0    100 14  3 0
4   16 3  0     151 16 2 0    31  16  3 0
125 11 2  0     130 13 5 0    112 16  3 0
140 11 5  0     93  16 3 0    1   9   3 0
52  6  5  1     20  9  6 0    91  12  5 1
73  1  5  1     35  13 3 0    143 3   9 0
61  1  4  0     97  16 3 0    139 10  3 1
136 15 4  0     131 13 5 0    121 3   3 1
177 14 2  0     68  10 5 0    9   17  2 0
139 6  10 1     2   17 2 0    140 15  4 0
72  15 5  0     2   13 3 0    120 8   5 1
51  9  7  0     102 13 3 0    130 1   4 1
114 8  7  1     81  1  4 0    118 16  3 0
118 16 4  0     17  10 4 0    195 17  2 0
159 13 4  0     18  11 4 0    15  16  5 0
158 15 4  0     127 12 4 0    87  16  4 0
206 10 4  0     11  15 3 0    178 15  4 0
157 13 3  1     26  13 7 0    120 13  2 0
42  6  7  1     36  13 4 0
;PROC GAM data=kyphosis;
model kyphosis = spline(NumVert,df=3)
spline(Age,df=3)
spline(StartVert,df=3)
/dist=logist;
output out=estimate p uclm lclm;
run;先來看看報表長什麼樣子。首先第一張是 Summary Statistics,裡面提供一些資料和參數估計過程的訊息,不是很重要,可以不看。
第二張才是重點。裡面包含三個報表。第一個報表表示當模式是用線性迴歸時所跑出的參數估計值。第二個報表是用 GAM 跑出的 smoother 參數估計值。第三個報表比較特別。此處利用 deviance analysis 來檢定比較 full model(包含全部 smoothing function)和 reduced model(少掉某一個 smoothing function)那個比較顯著。虛無假設則是 H0: reduce model vs H1: full model。如果後面的 p-value 小於 0.05 則表示拒絕 reduced model。反之則表示不拒絕 reduce model。以 Age 和 StartVert 來看,兩者的 p-value 分別是 0.0009 和 0.0350,皆小於 0.05。所以可以同時拒絕分別少了這兩個變數的 reduced model。而 NumVert 的 p-value 為 0.3311 > 0.05,表示不拒絕少了 NumVert 的 smoothing function 的 reduced model,亦即是說 f(NumVert) 在模式中是不顯著的。
之後可針對偏預測值(partial prediction)來做圖。偏預測值的定義是固定其餘的預測變數,來看某預測變數變動對反應變數的影響。由這些圖也可以看出預測變數的顯著性。如果預測變數的 95% 信賴區間完全涵蓋住 0 的話就表示該預測變數不顯著。
以第一張圖來看,NumVert 的 95% CI 完全包含 y=0,所以不顯著。Age(第二張圖)則是部分涵蓋,可視為顯著。比較有爭議的是 StartVert 的圖(第三張)。從圖形上來看,95% CI 應該算是完全包含了 y=0,可是末端有一小段相當逼近 y=0。原文並沒有特別說明這種情況該怎樣判斷,因此各位最好還是單純從 analysis of deviance 裡面的 p-value 來判斷,而不能完全應該偏預測值圖。此外,從 Age 和 StartVert 的偏預測值趨勢圖也可看出這兩個變數和反應變數有稍微二次項的關係。
PROC GAM 就是這麼簡單。不過,從 GAM 延伸出來的變形模式還有很多。有機會再來講 Bayesian analysis 搭配 GAM 的使用。
Contact Information
Dong Xiang, SAS Institute Inc., SAS Campus Drive,
Cary, NC 27513. Phone (919) 531-4854, FAX (919)
677-4444, Email dong.xiang@sas.com.
2007年6月28日 星期四
Model Selection in PROC MIXED - A User-friendly SAS® Macro Application
原文載點:http://www2.sas.com/proceedings/forum2007/191-2007.pdf
這一篇 SUGI 技術文件是我個人認為本年度最重要的發表之一。Mixed model 在九零年代初期才正式被 SAS 納入為正規的 procedure 語法裡面(也就是 proc mixed)。在此之前,想要配適 mixed model 的人只能用一些已經發表出來的 macro 程式下去跑,極為不方便。可是,縱使有 proc mixed 的出現,還是不能解決大多數人所遇到的問題,那就是 mixed model 配適過程中進行模式選取的複雜性。University of Nevada- Reno 統計系教授 George Fernandez 在多年前就開始進行簡化 mixed model 模式選取複雜性的技術研究,並不斷改良他的程式發表在每一年度的 SUGI 上。今年在 SAS Global Forum 2007 年會上,他終於發佈了一個「終極完整版」的簡化程式(以下簡稱 ALLMIXED2)。使用者可以在一個固定的介面底下輸入少量指令,然後讓 SAS 自動進行 pre-screen、model selection 和 model diagnostic 的動作。
這份技術文件長達二十頁,可是並沒有詳細提到 ALLMIXED2 的使用方法,反而著重在 IC(information criteria)在模式選取上所扮演的角色。但基本上我們都知道,無論是使用哪一種 IC(AIC、AICC、BIC and so on...),越小的 IC 值表示該模式越好。雖然這個判定方法有一些缺點(嚴謹一點的人則愛用 LRT(Likelihood Ratio Test)),但這仍舊是一個相當重要的指標。至於真正 ALLMIXED2 的使用方法,則是放在 George Fernandez 的網站裡面。
ALLMIXED2 有下列一些特點:
ALLMIXED2 和詳細的使用步驟解說(共計有五大步驟)都放在 Georage Fernandez 的網站上:http://www.ag.unr.edu/gf。但說實在的,他的網頁版面設計的很亂(如下所示)。
想要找到載點,請先點右邊頁框中有隻跑來跑去的灰色小狗。然後會出現一段宣告:
Quick Results from Data analysis Demo Agreement
By clicking the "Accept" button you are agreeing to the following :
THE INFORMATION, CODE AND EXECUTABLES PROVIDED ARE PROVIDED AS IS WITHOUT WARRANTY OF ANY KIND, EITHER EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE. IN NO EVENT SHALL George Fernandez BE LIABLE FOR ANY DAMAGES WHATSOEVER INCLUDING DIRECT, INDIRECT, INCIDENTAL, CONSEQUENTIAL, LOSS OF BUSINESS PROFITS OR SPECIAL DAMAGES, EVEN IF George Fernandez HAS BEEN ADVISED OF THE POSSIBILITY OF SUCH DAMAGES.
點選「Accept」後,會要求你填寫個人基本資料。填完後按「Submit Comments」,就可以下載程式和說明使用手冊了。
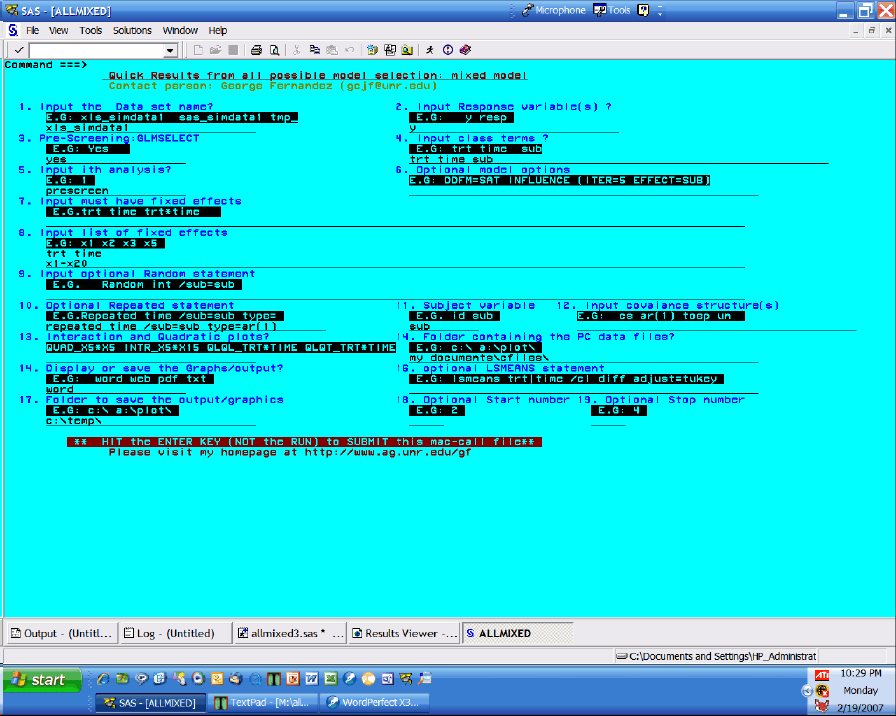
接著,讓我先來介紹整個 ALLMIXED2 介面的內容。
Step 1: Variable Pre-screen Using SAS GLMSELECT
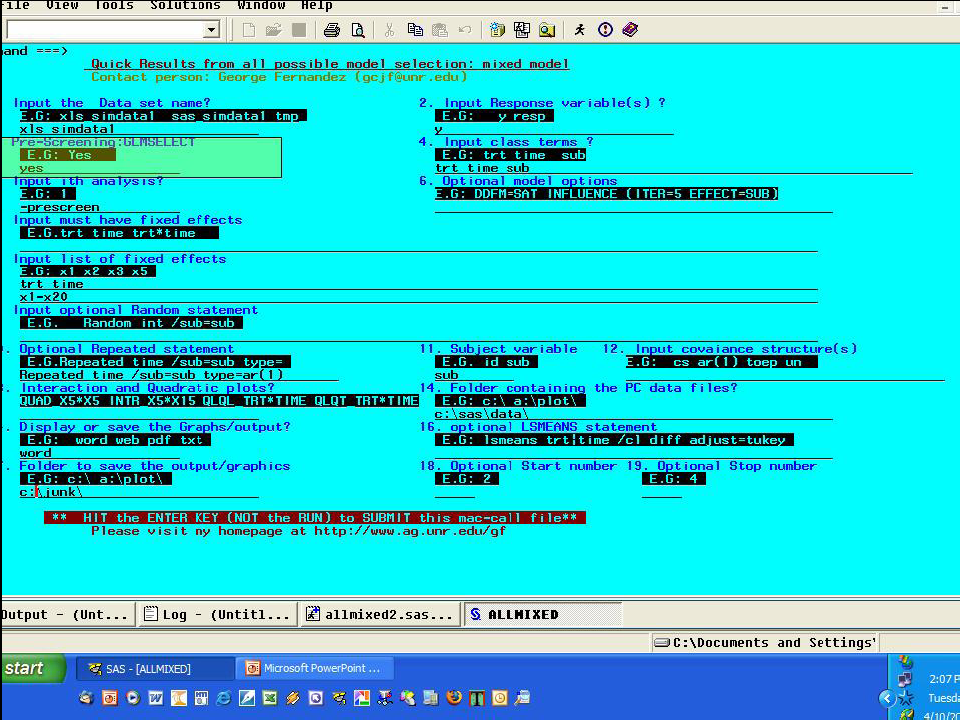
步驟一主要是在進行獨立變數預先篩選的動作。如果資料內並沒有很多變數,則此步驟可以跳過。此外,由於這個步驟需要使用 PROC GLMSELECT 程序。目前的 SAS V9.1 版並沒有這個程式可供執行,所以必須到 SAS 官網下載外掛程式安裝。
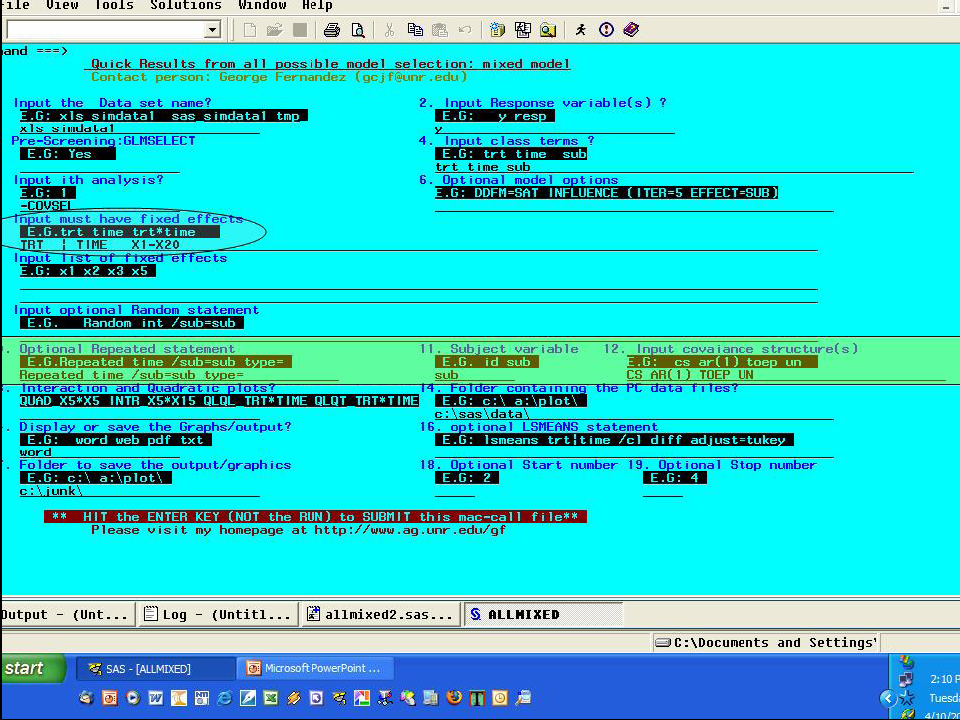
步驟二是要找出最佳的 covariance structure。
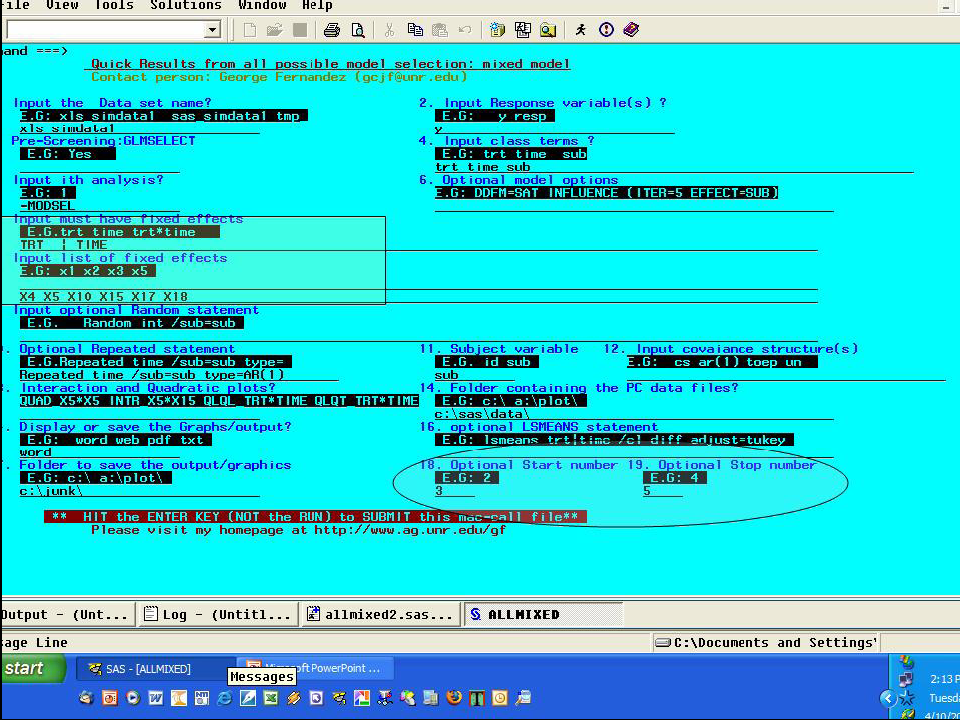
步驟三是在步驟二決定了最佳的 covariance structure(ar(1))之後,開始進行模式選取的動作以找出 the best model。
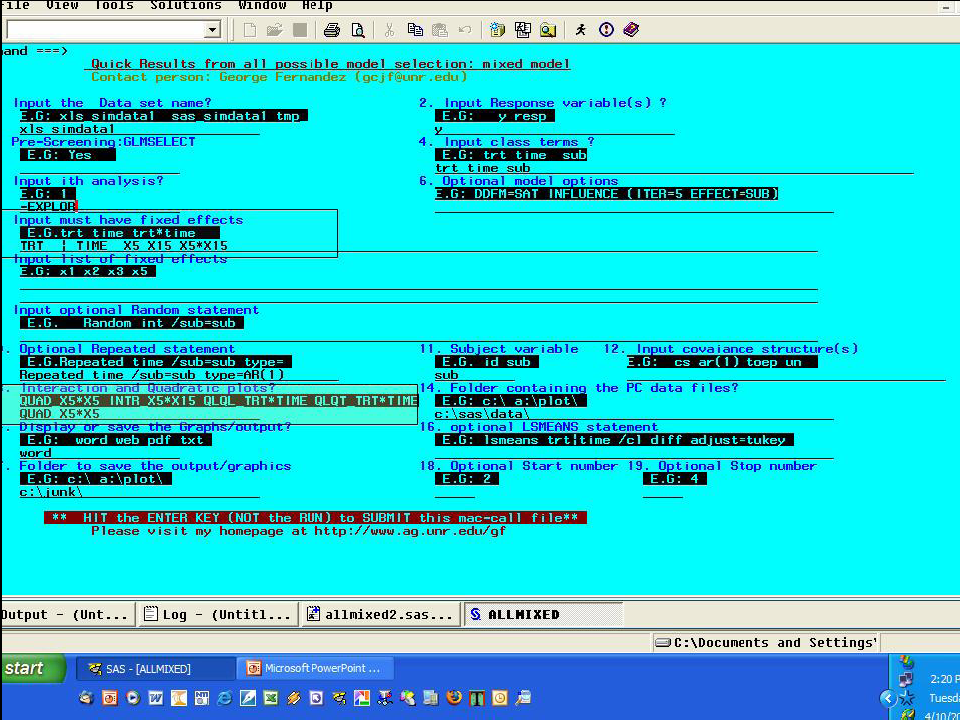
步驟四是在進行一些探索性統計圖表的繪製。
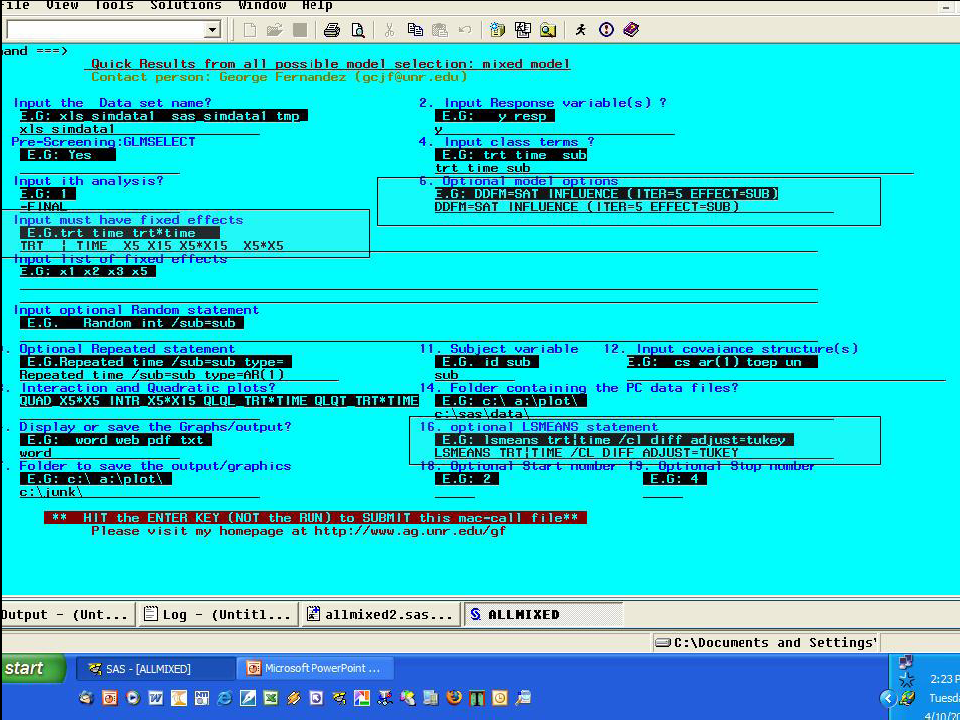
此步驟是在進行模式診斷。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author:
Name: Dr. George C. Fernandez,
Enterprise: University of Nevada - Reno
Address: CABNR/204 Reno, NV 89557
Work phone: (775)-784-4206
Email: gcjf@unr.edu
Web: Http://www.ag.unr.edu/gf
這一篇 SUGI 技術文件是我個人認為本年度最重要的發表之一。Mixed model 在九零年代初期才正式被 SAS 納入為正規的 procedure 語法裡面(也就是 proc mixed)。在此之前,想要配適 mixed model 的人只能用一些已經發表出來的 macro 程式下去跑,極為不方便。可是,縱使有 proc mixed 的出現,還是不能解決大多數人所遇到的問題,那就是 mixed model 配適過程中進行模式選取的複雜性。University of Nevada- Reno 統計系教授 George Fernandez 在多年前就開始進行簡化 mixed model 模式選取複雜性的技術研究,並不斷改良他的程式發表在每一年度的 SUGI 上。今年在 SAS Global Forum 2007 年會上,他終於發佈了一個「終極完整版」的簡化程式(以下簡稱 ALLMIXED2)。使用者可以在一個固定的介面底下輸入少量指令,然後讓 SAS 自動進行 pre-screen、model selection 和 model diagnostic 的動作。
這份技術文件長達二十頁,可是並沒有詳細提到 ALLMIXED2 的使用方法,反而著重在 IC(information criteria)在模式選取上所扮演的角色。但基本上我們都知道,無論是使用哪一種 IC(AIC、AICC、BIC and so on...),越小的 IC 值表示該模式越好。雖然這個判定方法有一些缺點(嚴謹一點的人則愛用 LRT(Likelihood Ratio Test)),但這仍舊是一個相當重要的指標。至於真正 ALLMIXED2 的使用方法,則是放在 George Fernandez 的網站裡面。
ALLMIXED2 有下列一些特點:
- 可以吃各種不同格式的資料(SAS data files, EXCEL, Access, txt)
- 可以一次輸入兩個以上的 Y(反應變數),讓程式可以同時去配適不同的模式。
- 針對可能含有大量變數的資料,可以先執行 pre-screen 流程讓 GLMSELECT 把一些不重要的變數挑掉。若變數不多,則可以跳掉這個步驟。
- 可找出使模式最佳的 covariance structure。
- 可以強迫某些變數一定要放在模式中而不被刪除,無論這些變數是否顯著。
- 可以對變數進行線性(linear)、二次項(quadratic)和交互作用項(interaction)的檢定。另外,還可檢定模式是否具有多重共線性(multicollinearity)。
- 可以進行模式診斷以檢測是否具有離群值。
- 可將結果存成 Word, HTML 和 PDF 檔格式。SAS log 和 error 訊息也可另存新檔。
- 無法進行變數三次項(cubic)的檢定
- 無法進行 linear spline mixed model 的模式配適。
- 無法使用 estimate 和 contrast 指令。
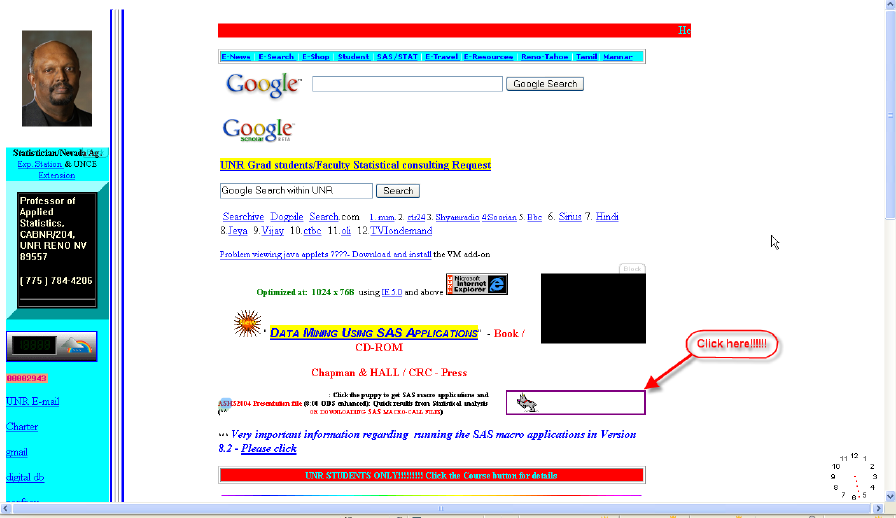
ALLMIXED2 和詳細的使用步驟解說(共計有五大步驟)都放在 Georage Fernandez 的網站上:http://www.ag.unr.edu/gf。但說實在的,他的網頁版面設計的很亂(如下所示)。
想要找到載點,請先點右邊頁框中有隻跑來跑去的灰色小狗。然後會出現一段宣告:
Quick Results from Data analysis Demo Agreement
By clicking the "Accept" button you are agreeing to the following :
THE INFORMATION, CODE AND EXECUTABLES PROVIDED ARE PROVIDED AS IS WITHOUT WARRANTY OF ANY KIND, EITHER EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE. IN NO EVENT SHALL George Fernandez BE LIABLE FOR ANY DAMAGES WHATSOEVER INCLUDING DIRECT, INDIRECT, INCIDENTAL, CONSEQUENTIAL, LOSS OF BUSINESS PROFITS OR SPECIAL DAMAGES, EVEN IF George Fernandez HAS BEEN ADVISED OF THE POSSIBILITY OF SUCH DAMAGES.
點選「Accept」後,會要求你填寫個人基本資料。填完後按「Submit Comments」,就可以下載程式和說明使用手冊了。
接著,讓我先來介紹整個 ALLMIXED2 介面的內容。
- Input the Data set name? -- 輸入資料檔案名稱。特別要注意的是,副檔名必須寫在前面,以供程式知道資料檔案名稱格式。例如,檔案名稱是 SIMDATA1.sd7sas,則欄位內必須填寫 SAS_SIMDATA1。目前可供使用的資料檔案格式為 xls, tab, txt, mdb, SAS, TMP。
- Input Response variable(s)? -- 輸入反應變數。特別注意,這邊可以輸入多個反應變數,因為 ALLMIXED2 可以一次配適兩個以上的 mixed model。
- Pre-Screening: GLMSELECT -- 這個欄位是專門做獨立變數 X 預選的工作。如果你有超過二十個以上的獨立變數,ALLMIXED2 會啟動 PROC GLMSELECT 程序挑掉一些不重要的,差不多會留下最後十個比較重要的變數。輸入 yes 就會啟動。留著空白就不會啟動。
- Input class terms? -- 輸入離散型的變數。
- Input ith analysis? -- 你可以輸入任何數值或文字給你分析結果的輸出檔案加上註解。基本上填什麼都不會影響到分析結果。
- Optional model options -- 可以在任意在 model statement 後面加上各種 option。比方說若要進行模式診斷,則可以寫上 DDFM=SAT INFLUENCE (ITER=5 EFFECT=SUB)。由於這是選擇性欄位,所以留著空白也可以。
- Input must have fixed effects -- 根據不同研究的需要,有些變數是無論是否顯著都一定要放進模式裡面。如果有這些變數存在,那就需要將這些變數填入這個欄位裡面,否則可能會在模式選取的階段被挑掉。
- Input list of fixed effects -- 這個欄位就可以放進任何固定效果因子。ALLMIXED2 會針對這些因子做篩選的工作。共計兩行的空白欄位,可以輸入很多固定效果因子。
- Input optional Random statement -- 如果有隨機效果因子,則 random statement 的語法必須完整地填入這個空白欄位。如 random int / sub=sub。
- Optional Repeated statement -- 和欄位九一樣,如果需要輸入 repeated statement,就需要在這個欄位填入相關的程式,例如: repeated time / sub=sub type=ar(1)。
- Subject variable -- 填入 subject 變數的地方。
- Input covariance structure(s) -- 填入 covariance structure 的地方。這邊可以填入數個 covariance structure,程式會自動幫使用者挑出最好的 covariance structure。
- Interaction and quadratic plots? -- 可以繪製交互作用項以及二次項 vs 反應變數的圖形,並且分析是否顯著。
- Folder containing the PC data files -- 這是讓使用者指定原始資料檔案所放置的路徑位置。
- Display or save the Graphs/output? -- 可以讓使用者指定要存出報表的格式。目前可輸出的格式有 word, web, pdf 和 txt。
- optional LSMEANS statement -- 這是可以算 least square means 的欄位,但個人覺得相當無用。
- Folder to save the output/graphics -- 可讓使用者指定想要儲存輸出報表和圖檔的路徑位置。
- Optional Start number -- 在做模式選取時,開始篩選變數的起始值。如果輸入 2,則程式會從只包含兩個獨立變數的模式開始做模式選取。
- Optional stop number -- 在做模式選取時,結束篩選變數的終止時。如果輸入 5,則程式會進行模式選取值到最多只有五個獨立變數在模式。
Step 1: Variable Pre-screen Using SAS GLMSELECT
步驟一主要是在進行獨立變數預先篩選的動作。如果資料內並沒有很多變數,則此步驟可以跳過。此外,由於這個步驟需要使用 PROC GLMSELECT 程序。目前的 SAS V9.1 版並沒有這個程式可供執行,所以必須到 SAS 官網下載外掛程式安裝。
- Input the Data set name? -- 由於使用 EXCEL 資料格式,所以填入 xls_simdata1
- Input Response variable(s)? -- 輸入 y
- Pre-Screening: GLMSELECT -- 輸入 yes
- Input class terms? -- 輸入 trt time sub
- Input ith analysis? -- 輸入-prescreen
- Optional model options -- 本階段不需要,所以空白
- Input must have fixed effects -- 本階段不需要,所以空白
- Input list of fixed effects -- 把所有獨立變數放入,輸入 trt time x1-x20
- Input optional Random statement -- 本階段不需要,所以空白
- Optional Repeated statement -- 輸入 repeated time/sub=sub type=ar(1)
- Subject variable -- 輸入 sub
- Input covariance structure(s) -- 本階段不需要,所以空白
- Interaction and quadratic plots? -- 本階段不需要,所以空白
- Folder containing the PC data files -- 輸入 c:\sas\data\ (註:最後一個"\"不能漏掉)
- Display or save the Graphs/output? -- 輸入 word 表示要存成 word 檔
- optional LSMEANS statement -- 本階段不需要,所以空白
- Folder to save the output/graphics -- 輸入 c:\junk\(註:最後一個"\"不能漏掉)
- Optional Start number -- 本階段不需要,所以空白
- Optional stop number -- 本階段不需要,所以空白
步驟二是要找出最佳的 covariance structure。
- Input the Data set name? -- 輸入 xls_simdata1
- Input Response variable(s)? -- 輸入 y
- Pre-Screening: GLMSELECT -- 本階段不需要,所以空白
- Input class terms? -- 輸入 trt time sub
- Input ith analysis? -- 輸入 -COVSEL
- Optional model options -- 本階段不需要,所以空白
- Input must have fixed effects -- 輸入 trt|time x1-x20
- Input list of fixed effects -- 本階段不需要,所以空白
- Input optional Random statement -- 本階段不需要,所以空白
- Optional Repeated statement -- 輸入 repeated time/sub=sub type= (註:type=後面一定要空白)
- Subject variable -- 輸入 sub
- Input covariance structure(s) -- 輸入所有想要挑選的 covariance structure: cs ar(1) toep un
- Interaction and quadratic plots? -- 本階段不需要,所以空白
- Folder containing the PC data files -- 輸入 c:\sas\data\
- Display or save the Graphs/output? -- 輸入 word 表示要存成 word 檔
- optional LSMEANS statement -- 本階段不需要,所以空白
- Folder to save the output/graphics -- 輸入 c:\junk\
- Optional Start number -- 本階段不需要,所以空白
- Optional stop number -- 本階段不需要,所以空白
步驟三是在步驟二決定了最佳的 covariance structure(ar(1))之後,開始進行模式選取的動作以找出 the best model。
- Input the Data set name? -- 輸入 xls_simdata1
- Input Response variable(s)? -- 輸入 y
- Pre-Screening: GLMSELECT -- 本階段不需要,所以空白
- Input class terms? -- 輸入 trt time sub
- Input ith analysis? -- 輸入 -MODSEL
- Optional model options -- 本階段不需要,所以空白
- Input must have fixed effects -- 輸入 trt|time,因為這是強制他們進入模式
- Input list of fixed effects -- 輸入步驟一挑出來的變數 x4 x5 x10 x15 x17 x18
- Input optional Random statement -- 本階段不需要,所以空白
- Optional Repeated statement -- 輸入 repeated time/sub=sub type=ar(1)
- Subject variable -- 輸入 sub
- Input covariance structure(s) -- 本階段不需要,所以空白
- Interaction and quadratic plots? -- 本階段不需要,所以空白
- Folder containing the PC data files -- 輸入 c:\sas\data\
- Display or save the Graphs/output? -- 輸入 word
- optional LSMEANS statement -- 本階段不需要,所以空白
- Folder to save the output/graphics -- 輸入 c:\junk\
- Optional Start number -- 輸入 2(表示從二因子模式開始選)
- Optional stop number -- 輸入 5(表示模式內最多五因子)
步驟四是在進行一些探索性統計圖表的繪製。
- Input the Data set name? -- 輸入 xls_simdata2
- Input Response variable(s)? -- 輸入 y
- Pre-Screening: GLMSELECT -- 本階段不需要,所以空白
- Input class terms? -- 輸入 trt time sub
- Input ith analysis? -- 輸入 -EXPLOR
- Optional model options -- 本階段不需要,所以空白
- Input must have fixed effects -- 輸入 trt|time x5 x15 x5*x15(這是步驟三找出的最佳模式)
- Input list of fixed effects -- 本階段不需要,所以空白
- Input optional Random statement -- 本階段不需要,所以空白
- Optional Repeated statement -- 輸入 repeated time/sub=sub type=ar(1)
- Subject variable -- 輸入 sub
- Input covariance structure(s) -- 本階段不需要,所以空白
- Interaction and quadratic plots? -- 輸入 quad x5*x5(程式會畫出 x5 的二次項和反應變數的關係圖)
- Folder containing the PC data files -- 輸入 c:\sas\data\
- Display or save the Graphs/output? -- 輸入 word
- optional LSMEANS statement -- 本階段不需要,所以空白
- Folder to save the output/graphics -- 輸入 c:\junk\
- Optional Start number -- 本階段不需要,所以空白
- Optional stop number -- 本階段不需要,所以空白
此步驟是在進行模式診斷。
- Input the Data set name? -- 輸入 xls_simdata1
- Input Response variable(s)? -- 輸入 y
- Pre-Screening: GLMSELECT -- 本階段不需要,所以空白
- Input class terms? -- 輸入 trt time sub
- Input ith analysis? -- 輸入 -FINAL
- Optional model options -- 輸入 ddfm=sat influence (iter=5 effect=sib_
- Input must have fixed effects -- 輸入 trt|time x5 x15 x5*x15 x5*x5(步驟四檢定出 x5 的二次項是顯著的,所以在這個步驟加入此二次項)
- Input list of fixed effects -- 本階段不需要,所以空白
- Input optional Random statement -- 本階段不需要,所以空白
- Optional Repeated statement -- 輸入 repeated time/sub=sub type=ar(1)
- Subject variable -- 輸入 sub
- Input covariance structure(s) -- 本階段不需要,所以空白
- Interaction and quadratic plots? -- 本階段不需要,所以空白
- Folder containing the PC data files -- 輸入 c:\sas\data\
- Display or save the Graphs/output? -- 輸入 word
- optional LSMEANS statement -- 輸入 lsmeans trt|time /cl diff adjust=tukey
- Folder to save the output/graphics -- 輸入 c:\junk\
- Optional Start number -- 本階段不需要,所以空白
- Optional stop number -- 本階段不需要,所以空白
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author:
Name: Dr. George C. Fernandez,
Enterprise: University of Nevada - Reno
Address: CABNR/204 Reno, NV 89557
Work phone: (775)-784-4206
Email: gcjf@unr.edu
Web: Http://www.ag.unr.edu/gf
2007年6月12日 星期二
Solutions to Violations of Assumptions of Ordinary Least Squares Regression Models Using SAS®
原文載點:http://www2.sas.com/proceedings/forum2007/131-2007.pdf
筆者從事模式配適這檔子事情多年,最讓我感到困擾的模式倒不是 mixed model,而是一般人在大學時代修統計學時都會上過的線性迴歸模式。他難的地方不在模式配適的過程,而是在模式檢定步驟。由於整個線性迴歸模式是架構在許多相當嚴苛條件下,因此只要有任何一個假設條件不滿足原始的設定,那估計出來的參數、估計標準差、信賴區間和檢定都有可能是有偏誤的。無奈看過許多使用迴歸模式的研究報告,大部分的人都自動省略模式假設的檢定步驟,讓我對整篇報告打上大大個問號。當然,我瞭解許多非統計背景出身的學者可能不瞭解事情的嚴重性,或者覺得若要一一照著教科書上來做則根本不可能配出一個像樣的迴歸模式。但本著學術良知,我還是誠懇地建議這一步驟千萬不要省略。如果只想貪圖速成(迴歸模型的配適的確很快),那我通常會建議對方用其他模式去試看看。如果非用迴歸不可,那我就會先替他們做好心理建設。因為接下來有很多困難必須去面對,絕對不可能像教科書上的範例一樣那麼完美。
回到正題,迴歸模式的四大設訂不外乎是:一、線性,二、獨立,三、常態,四、變異數同質性。除了這四個假設是絕對不能違反以外,「共線性」也是一個不可忽略的問題,尤其當自變數相當多的時候。Leonor Ayyangar 在 SAS GLOBAL FORUM 2007 發表了一篇技術文件,一一說明如何用 SAS 來檢查上述四大設定和共線性,並提出當違反設定時的可能解決方法。
ASSUMPTION 1: LINEARITY
線性迴歸模式,從字面上看來,「線性」是他最主要的特徵。而線性的定義,是依變數和所有自變數間具有線性的關係。當使用簡單線性迴歸時,可以使用最簡單的 PROC CORR 來檢定 X 和 Y 是否具有線性關係。當使用複迴歸時,則需要看 partial residual plot。在 PROC REG 中,只需要在 model statement 後面加上 partial 這個 option 即可,如下所示:
當線性關係不存在時,最明顯的影響是會導致參數估計值產生偏誤。另一方面,R-square 值也會被低估。有幾個方法可以來解決這個問題:
一、將某些自變數分群,並把分群後的每一組都設定成一個 dummy variable。如果分成五群,則需產生四個 dummy variable 在模式裡面。
二、對自變數做變數變換。常見的變數變換有 log, inverse 或 polynomial。另外,spline transformation(使用 PROC TRANSREG)也是個不錯的點子。
三、使用非線性模式,如 PROC GENMOD。
ASSUMPTION 2: INDEPENDENCE OF ERROR TERMS
第二個假定是迴歸模式的誤差項一定是需要互相獨立的。如果不是獨立的話,則表示該模式有自相關(autocorrelation)的情況。
要檢定模式是否有自相關,則可對殘差進行 Durbin-Watson 檢定(簡稱 DW)。另外也可以做一張殘差和時間相關自變數的圖。如果沒有自相關的情況,則圖上的點不會呈現特殊的趨勢。程式如下所示:
另外,也可以使用 Lagrange Multiplier general test 來檢查。程式如下所示:
自相關會導致 T 統計量膨脹,使得估計係數的標準誤被低估。如此一來則參數的假設檢定會是錯誤的。遇到這種情況的話有幾個解決的方法:
一、作者提到不要只相信 DW test 的結果,而要去綜合地比較其他獨立性檢定。他推薦下面這個教科書中的 p.142 可提供更詳盡的說明:
Kennedy, Peter. (1992). A Guide to Econometrics. Cambridge, MA: Massachusetts Institute of Technology Press. Neter, Wasserman, and Kunter (1990). Applied Linear Statistical Models, 3rd ed., Irwin.
二、對自變數或依變數做 lag 變數變換(注意!是 lag,不是 log)。
三、考慮 time series model(使用 PROC AUTOREG)。
ASSUMPTION 3: εi ~ N(0,σ2)
誤差項需服從常態分配,應該是這幾個假設中最最最重要的一項。此外,變異數同質性也是不可忽略的(但卻經常被忽略!)。要檢定常態性,則必須將殘差抓出來進行 Shapiro-Wilk test 或 Kolmogorov-Smirnov test。Q-Q plot 也可以當作輔助判斷工具。這些檢定都可以用 PROC UNIVARIATE 完成,如下所示:
欲檢驗模式是否有異質性(heteroskedasticity)的問題,可以進行 White test(在 model statement 後面加上 spec),或者去繪製殘差 v.s. 預測值的圖:
違反上述這兩個假設,幾乎可以宣判該迴歸模式死刑!因為所有的估計值和檢定都會因為這兩個假定違反而產生完全錯誤的結果,後果相當嚴重。解決方法有:
一、對依變數做變數變換。常見的變數變換為 square root, log 和 reciprocal。此外,作者也推薦使用 Duan's smearing operator。關於這個東西,詳見下面這個 paper:
Duan N. Smearing estimate: a nonparametric retransformation method. Journal of the American Statistical Association 1983;78:605-610.
二、使用加權最小平方法(Weighted Least Square)。在 SAS code 裡面是加上一行 weight statement,然後指定要加權的自變數。
三、考慮 robust regression(詳見 PROC ROBUSTREG)。
ASSUMPTION 4 : MEAN INDEPENDENCE : E[εi |Xij]=0
這個假定比較少人知道。在計量經濟學裡面,違反這個假定則稱為 endogeneity(中文不知道該怎樣翻譯)。若違反這個假定,可能會導致參數估計值偏誤。在 PROC REG 中,同樣使用 SPEC option 可產生相關的檢定數據。若違反這個假定,作者推薦改用 PROC SYSLIN 去做調整。
ASSUMPTION 5: Xi IS UNCORRELATED TO Xj , i ≠ j
其實這個假定若出現問題,則共線性的問題就跟著跑了出來。因此簡而言之,這部分就是在檢定模式是否具有共線性(或稱多重共線性)。在迴歸模式中,可使用變異數膨脹係數(VIF)或容忍值(tolerance)來當作判定共線性是否存在的標準。一般來說,VIF 大於 10 或 tolerance 小於 0.1 則表示有共線性的問題。在 SAS 內計算這兩個值只需要在 model statement 後面加上 VIF 和 tol 這兩個 option 即可,如下所示:
若一個迴歸模式有共線性的問題,最容易產生的麻煩就是會讓自變數的估計參數產生異常的變動。根據筆者的經驗,在迴歸模式中最容易看出受到共線性影響的地方是,一個按照常理應該是「正」的估計參數(也就表示那個 X 和 Y 是正相關),結果估出來的係數是負的!以下有幾個方法可以解決共線性的問題:
一、適度移除幾個具有互相高度相關的自變數。
二、移除全部具有互相高度相關的自變數,而改用其交互作用項。
三、增加樣本數。
四、(這是我自己加的)使用主成分(principal components)或山脊型迴歸法(ridge regression procedure)來進行迴歸分析。其中,利用主成分來進行迴歸分析是一個相當具有高難度的技術。即利用多變量分析中的主成分分析法將所有自變數統整濃縮成幾個具有代表性的主成分因子,並重新命名(這部分是個「藝術」,相當具有挑戰性)。最後裡用這些重新命名後的主成分因子來配適迴歸模型。
總而言之,上述所有的檢定都可以利用 SAS 輕鬆完成,但困難地方在於當假定違反時該如何去進行調整。這還牽涉到一個更深入的問題,就是當利用變數變換來進行調整後,做出來的新的迴歸模式是不是(或能不能)做出合理解釋。這一切的一切都仰賴經驗的累積,非一朝一夕能夠學起。有志於大量使用線性迴歸來進行研究的朋友們,我只能說:God bless you。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Leonor Ayyangar
Health Economics Resource Center (HERC)
Palo Alto VA Health Care System
795 Willow Road, (152 MPD)
Menlo Park, CA 94025
Phone: (650) 493-5000 Ext. 22338
E-mail: Leonor.Ayyangar@va.gov
筆者從事模式配適這檔子事情多年,最讓我感到困擾的模式倒不是 mixed model,而是一般人在大學時代修統計學時都會上過的線性迴歸模式。他難的地方不在模式配適的過程,而是在模式檢定步驟。由於整個線性迴歸模式是架構在許多相當嚴苛條件下,因此只要有任何一個假設條件不滿足原始的設定,那估計出來的參數、估計標準差、信賴區間和檢定都有可能是有偏誤的。無奈看過許多使用迴歸模式的研究報告,大部分的人都自動省略模式假設的檢定步驟,讓我對整篇報告打上大大個問號。當然,我瞭解許多非統計背景出身的學者可能不瞭解事情的嚴重性,或者覺得若要一一照著教科書上來做則根本不可能配出一個像樣的迴歸模式。但本著學術良知,我還是誠懇地建議這一步驟千萬不要省略。如果只想貪圖速成(迴歸模型的配適的確很快),那我通常會建議對方用其他模式去試看看。如果非用迴歸不可,那我就會先替他們做好心理建設。因為接下來有很多困難必須去面對,絕對不可能像教科書上的範例一樣那麼完美。
回到正題,迴歸模式的四大設訂不外乎是:一、線性,二、獨立,三、常態,四、變異數同質性。除了這四個假設是絕對不能違反以外,「共線性」也是一個不可忽略的問題,尤其當自變數相當多的時候。Leonor Ayyangar 在 SAS GLOBAL FORUM 2007 發表了一篇技術文件,一一說明如何用 SAS 來檢查上述四大設定和共線性,並提出當違反設定時的可能解決方法。
ASSUMPTION 1: LINEARITY
線性迴歸模式,從字面上看來,「線性」是他最主要的特徵。而線性的定義,是依變數和所有自變數間具有線性的關係。當使用簡單線性迴歸時,可以使用最簡單的 PROC CORR 來檢定 X 和 Y 是否具有線性關係。當使用複迴歸時,則需要看 partial residual plot。在 PROC REG 中,只需要在 model statement 後面加上 partial 這個 option 即可,如下所示:
PROC REG data=cabgdata;
MODEL dsur_tot = totmin iopktrf rbc savebld toticu age numcomplic / partial;
TITLE’ Graphical Test of Linearity Assumption’;
QUIT;
當線性關係不存在時,最明顯的影響是會導致參數估計值產生偏誤。另一方面,R-square 值也會被低估。有幾個方法可以來解決這個問題:
一、將某些自變數分群,並把分群後的每一組都設定成一個 dummy variable。如果分成五群,則需產生四個 dummy variable 在模式裡面。
二、對自變數做變數變換。常見的變數變換有 log, inverse 或 polynomial。另外,spline transformation(使用 PROC TRANSREG)也是個不錯的點子。
三、使用非線性模式,如 PROC GENMOD。
ASSUMPTION 2: INDEPENDENCE OF ERROR TERMS
第二個假定是迴歸模式的誤差項一定是需要互相獨立的。如果不是獨立的話,則表示該模式有自相關(autocorrelation)的情況。
要檢定模式是否有自相關,則可對殘差進行 Durbin-Watson 檢定(簡稱 DW)。另外也可以做一張殘差和時間相關自變數的圖。如果沒有自相關的情況,則圖上的點不會呈現特殊的趨勢。程式如下所示:
PROC REG data=cabgdata;
MODEL dsur_tot = totmin rbc savebld toticu age numcomplic/dw;
OUTPUT OUT=autocorr_test (keep= timepd res)
RESIDUAL=res;
TITLE’ Durbin-Watson Test of Autocorrelation';
QUIT;

PROC PLOT data=autocorr_test;
PLOT RES*timepd;
TITLE’Graphical test of autocorrelation’;
QUIT;
另外,也可以使用 Lagrange Multiplier general test 來檢查。程式如下所示:
PROC REG data=in.sampledata;
MODEL dsur_tot = totmin rbc savebld toticu age numcomplic;
TITLE’Output Residuals and Calculate their Lagged Values’;
OUTPUT OUT=outres
RESIDUAL=res;
DATA LMTest;
SET outres;
lagresid=lag(res);
label lagresid='lagged residual';
PROC REG;
MODEL res = totmin rbc savebld toticu age numcomplic lagresid;
TITLE’Lagrange Multiplier Test of Serial Correlation (Ho: No serial correlation)’;
QUIT;
自相關會導致 T 統計量膨脹,使得估計係數的標準誤被低估。如此一來則參數的假設檢定會是錯誤的。遇到這種情況的話有幾個解決的方法:
一、作者提到不要只相信 DW test 的結果,而要去綜合地比較其他獨立性檢定。他推薦下面這個教科書中的 p.142 可提供更詳盡的說明:
Kennedy, Peter. (1992). A Guide to Econometrics. Cambridge, MA: Massachusetts Institute of Technology Press. Neter, Wasserman, and Kunter (1990). Applied Linear Statistical Models, 3rd ed., Irwin.
二、對自變數或依變數做 lag 變數變換(注意!是 lag,不是 log)。
三、考慮 time series model(使用 PROC AUTOREG)。
ASSUMPTION 3: εi ~ N(0,σ2)
誤差項需服從常態分配,應該是這幾個假設中最最最重要的一項。此外,變異數同質性也是不可忽略的(但卻經常被忽略!)。要檢定常態性,則必須將殘差抓出來進行 Shapiro-Wilk test 或 Kolmogorov-Smirnov test。Q-Q plot 也可以當作輔助判斷工具。這些檢定都可以用 PROC UNIVARIATE 完成,如下所示:
PROC REG data=cabgdata;
MODEL dsur_tot = totmin rbc savebld toticu age numcomplic;
OUTPUT OUT=outres
RESIDUAL=res PREDICTED=Yhat;
QUIT;

PROC UNIVARIATE data=outres normal;
VAR res;
HISTOGRAM res / normal;
PROBPLOT res;
TITLETests for Normality of Residuals';
QUIT;
欲檢驗模式是否有異質性(heteroskedasticity)的問題,可以進行 White test(在 model statement 後面加上 spec),或者去繪製殘差 v.s. 預測值的圖:
PROC REG data=in.cohort;
MODEL dsur_tot = totmin rbc savebld toticu age numcomplic/spec;
TITLE ’White Test of Heteroskedasticity’;
QUIT;
違反上述這兩個假設,幾乎可以宣判該迴歸模式死刑!因為所有的估計值和檢定都會因為這兩個假定違反而產生完全錯誤的結果,後果相當嚴重。解決方法有:
一、對依變數做變數變換。常見的變數變換為 square root, log 和 reciprocal。此外,作者也推薦使用 Duan's smearing operator。關於這個東西,詳見下面這個 paper:
Duan N. Smearing estimate: a nonparametric retransformation method. Journal of the American Statistical Association 1983;78:605-610.
二、使用加權最小平方法(Weighted Least Square)。在 SAS code 裡面是加上一行 weight statement,然後指定要加權的自變數。
三、考慮 robust regression(詳見 PROC ROBUSTREG)。
ASSUMPTION 4 : MEAN INDEPENDENCE : E[εi |Xij]=0
這個假定比較少人知道。在計量經濟學裡面,違反這個假定則稱為 endogeneity(中文不知道該怎樣翻譯)。若違反這個假定,可能會導致參數估計值偏誤。在 PROC REG 中,同樣使用 SPEC option 可產生相關的檢定數據。若違反這個假定,作者推薦改用 PROC SYSLIN 去做調整。
ASSUMPTION 5: Xi IS UNCORRELATED TO Xj , i ≠ j
其實這個假定若出現問題,則共線性的問題就跟著跑了出來。因此簡而言之,這部分就是在檢定模式是否具有共線性(或稱多重共線性)。在迴歸模式中,可使用變異數膨脹係數(VIF)或容忍值(tolerance)來當作判定共線性是否存在的標準。一般來說,VIF 大於 10 或 tolerance 小於 0.1 則表示有共線性的問題。在 SAS 內計算這兩個值只需要在 model statement 後面加上 VIF 和 tol 這兩個 option 即可,如下所示:
PROC REG data=in.sampledata;
MODEL tcst_tot = tsur_tot age los /vif tolerance collinoint;
TITLE’ Test for Multicollinearity’;
QUIT;
若一個迴歸模式有共線性的問題,最容易產生的麻煩就是會讓自變數的估計參數產生異常的變動。根據筆者的經驗,在迴歸模式中最容易看出受到共線性影響的地方是,一個按照常理應該是「正」的估計參數(也就表示那個 X 和 Y 是正相關),結果估出來的係數是負的!以下有幾個方法可以解決共線性的問題:
一、適度移除幾個具有互相高度相關的自變數。
二、移除全部具有互相高度相關的自變數,而改用其交互作用項。
三、增加樣本數。
四、(這是我自己加的)使用主成分(principal components)或山脊型迴歸法(ridge regression procedure)來進行迴歸分析。其中,利用主成分來進行迴歸分析是一個相當具有高難度的技術。即利用多變量分析中的主成分分析法將所有自變數統整濃縮成幾個具有代表性的主成分因子,並重新命名(這部分是個「藝術」,相當具有挑戰性)。最後裡用這些重新命名後的主成分因子來配適迴歸模型。
總而言之,上述所有的檢定都可以利用 SAS 輕鬆完成,但困難地方在於當假定違反時該如何去進行調整。這還牽涉到一個更深入的問題,就是當利用變數變換來進行調整後,做出來的新的迴歸模式是不是(或能不能)做出合理解釋。這一切的一切都仰賴經驗的累積,非一朝一夕能夠學起。有志於大量使用線性迴歸來進行研究的朋友們,我只能說:God bless you。
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Leonor Ayyangar
Health Economics Resource Center (HERC)
Palo Alto VA Health Care System
795 Willow Road, (152 MPD)
Menlo Park, CA 94025
Phone: (650) 493-5000 Ext. 22338
E-mail: Leonor.Ayyangar@va.gov
2007年6月11日 星期一
Saving Trees with Output Delivery System (ODS)
原文載點:http://www2.sas.com/proceedings/forum2007/057-2007.pdf
一般人在配適模式的時候,可能由於變數很多,所以整個報表落落長。大家比較會注重最後的參數估計表,笨方法就是找到那個表格然後剪下來貼在其他的文書處理軟體中,聰明的人會用 ODS 把那個表格單獨存成 rtf 檔。但如果要配適的模式很多,要用到很多 procedure,最好還是用一些 macro 來解決冗長的程式碼。Angelina D. Tan, Nancy Dilehl, Jay N. Mandrekar 在 SAS Global Forum 2007 (SUGI 今年把名稱改成 SAS Global Forum了)中發表了三個「懶人 macro 包」,讓懶得寫那麼多 SAS code 的人能夠輕鬆配適模式,並且用 ODS 和 proc report 把參數估計表美美的存出來。
Regression model
macro 程式如下:
這個 macro 包含五個參數:
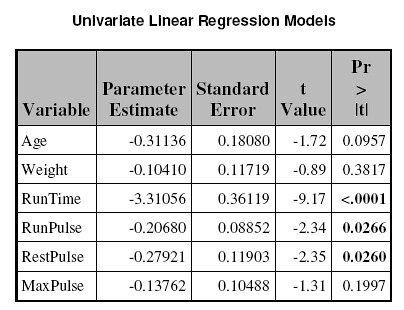
此範例是使用在 tana 這個 library 裡面的 fitness 資料檔。自變數是 Age、Weight、RunTime、RunPulse、RestPulse 和 MaxPulse 共計六個。依變數是 Oxygen,而參數估計表則另存到 preg 這個資料檔裡面。
然後便可以用下面這個 prog report 指令把參數估計表很完美地打印在 preg.doc 這個檔案裡面。我建議使用者不用太需要理會裡面的設定,只要記得把 ods rtf 後面的設定改成你要的路徑和檔名即可。當然如果你想要用別的 title 的話也可以把 title1 後面那串字改掉。不過基本上其他的程式碼都不需要變動。
如果你覺得這種兩階段的程式還是太麻煩,可以把上面的 proc report 程序丟進 pReg 裡面,但必須把 ods rtf 那行改成 macro 變數: ods rtf file="&filename"; 並將 macro 程式第一行改成: %macro pReg (dsn=, varlist=, numvars=, respvar=, outdsn=table, filename);
Logistic regression model
macro 程式如下:
同樣有五個參數,定義完全和 pReg 雷同。在此不多加描述。
使用範例如下:
然後用 proc report 列印參數估計表:
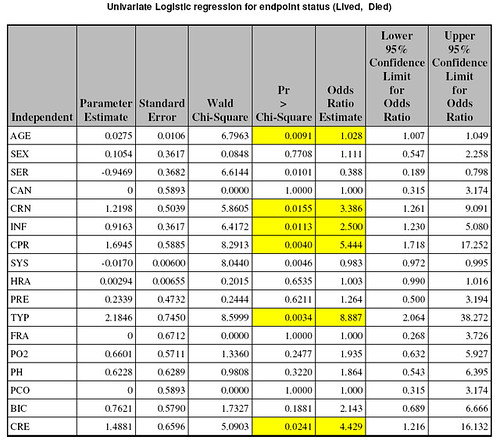
這個打印出來的參數估計表比較炫,會把顯著的參數用高亮度的黃色標記出來。
Cox PH model
macro 程式如下:
這個 macro 使用到的參數有七個:
最後還是要用 ODS 和 proc report 把參數估計表存出來:
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Angelina Tan
Mayo Clinic, Division of Biostatistics
200 First Street SW
Rochester MN 55905
Phone: 507-284 5743
Fax: 507-266 2477
Email: tan.angelina@mayo.edu
一般人在配適模式的時候,可能由於變數很多,所以整個報表落落長。大家比較會注重最後的參數估計表,笨方法就是找到那個表格然後剪下來貼在其他的文書處理軟體中,聰明的人會用 ODS 把那個表格單獨存成 rtf 檔。但如果要配適的模式很多,要用到很多 procedure,最好還是用一些 macro 來解決冗長的程式碼。Angelina D. Tan, Nancy Dilehl, Jay N. Mandrekar 在 SAS Global Forum 2007 (SUGI 今年把名稱改成 SAS Global Forum了)中發表了三個「懶人 macro 包」,讓懶得寫那麼多 SAS code 的人能夠輕鬆配適模式,並且用 ODS 和 proc report 把參數估計表美美的存出來。
Regression model
macro 程式如下:
%macro pReg (dsn=, varlist=, numvars=, respvar=, outdsn=table);
%do j=1 %to &numvars.;
%let var2=%scan(&varlist.,&amp;amp;amp;j.,' ');
ods select none;
ods output ParameterEstimates=work.pe&j. ;
proc reg data=&dsn.;
model &respvar. = &amp;amp;amp;var2. ;
run;
ods select all;
data pe&j.;
set pe&j.;
keep Variable Estimate StdErr tValue Probt ;
if Variable="Intercept" then delete;
run;
%if &j.=1 %then %do;
data &outdsn.;
set pe1;
run;
%end;
%else %do;
data &outdsn.;
set &outdsn. pe&amp;amp;amp;j.;
run;
%end;
%end;
%mend pReg;這個 macro 包含五個參數:
- dsn = 輸入資料來源檔
- varlist = 自變數
- numvars = 自變數個數
- respvar = 依變數
- outdsn = 輸出參數估計表的資料檔名(預設值=table)
%pReg (dsn =tana.fitness,
Varlist =Age Weight RunTime RunPulse RestPulse MaxPulse,
numvars =6,
respvar =Oxygen,
outdsn =preg);
此範例是使用在 tana 這個 library 裡面的 fitness 資料檔。自變數是 Age、Weight、RunTime、RunPulse、RestPulse 和 MaxPulse 共計六個。依變數是 Oxygen,而參數估計表則另存到 preg 這個資料檔裡面。
然後便可以用下面這個 prog report 指令把參數估計表很完美地打印在 preg.doc 這個檔案裡面。我建議使用者不用太需要理會裡面的設定,只要記得把 ods rtf 後面的設定改成你要的路徑和檔名即可。當然如果你想要用別的 title 的話也可以把 title1 後面那串字改掉。不過基本上其他的程式碼都不需要變動。
ods rtf file='h:\ibm\preg.doc';
title1 'Simple Linear Regression Model';
proc report data=preg box nowd split=' ';
column Variable Estimate StdErr tValue Probt ;
define Variable / display;
define Estimate / display;
define StdErr / display;
define tValue / display;
define Probt / display;
compute probt;
if probt <= 0.05 then call define('_c5_','style','style=[font_weight=bold]'); endcomp; run; ods rtf close;
如果你覺得這種兩階段的程式還是太麻煩,可以把上面的 proc report 程序丟進 pReg 裡面,但必須把 ods rtf 那行改成 macro 變數: ods rtf file="&filename"; 並將 macro 程式第一行改成: %macro pReg (dsn=, varlist=, numvars=, respvar=, outdsn=table, filename);
Logistic regression model
macro 程式如下:
%macro pLogistic (dsn=, varlist=, numvars=, respvar=, outdsn=table);
%do j=1 %to &numvars.;
%let var2=%upcase(%scan(&varlist.,&amp;amp;amp;j.,' '));
ods select none;
ods output ParameterEstimates=work.pe&j. OddsRatios=work.or&amp;amp;amp;j. ;
proc logistic data= &dsn. descending;
model &respvar.= &amp;amp;amp;var2. /link=logit ;
run;
ods select all;
data pe&j.;
length Independent $20;
set pe&j.;
rename ProbChiSq=Waldp;
keep Independent Estimate StdErr WaldChiSq ProbChiSq;
Independent="&var2.";
if upcase(Variable)="&var2.";
run;
proc sort data=pe&j.;
by Independent;
run;
data or&j;
length Independent $20;
set or&j.;
rename OddsRatioEst=OREst;
keep Independent OddsRatioEst LowerCL UpperCL;
Independent="&var2.";
if upcase(Effect)="&var2.";
run;
proc sort data=or&j.;
by Independent;
run;
data all&j.;
merge pe&j. or&amp;amp;amp;j.;
by Independent;
run;
%if &j.=1 %then %do;
data &outdsn.;
set all1;
run;
%end;
%else %do;
data &outdsn.;
set &outdsn. all&amp;amp;amp;j;
run;
%end;
%end;
%mend pLogistic;同樣有五個參數,定義完全和 pReg 雷同。在此不多加描述。
使用範例如下:
%pLogistic (dsn =tana.icu,
Varlist =AGE SEX SER CAN CRN INF CPR SYS HRA PRE TYP FRA PO2 PH PCO BIC CRE,
Numvars =17,
Respvar =STA,
outdsn =plog);
然後用 proc report 列印參數估計表:
ods rtf file=''h:\ibm\plogistic.doc';
title1 'Univariate Logistic regression for endpoint status (Lived, Died)';
proc report data=plog box nowd split=' ';
column Independent Estimate StdErr WaldChiSq Waldp OREst LowerCL
UpperCL;
define Estimate / display;
define StdErr / display;
define WaldChiSq / display;
define Waldp / display;
define OREst / display;
define LowerCL / display;
define UpperCL / display;
compute orest;
if waldp <0.05> 1 then do;
call define('_c5_','style','style=[background=yellow]');
call define('_c6_','style','style=[background=yellow]');
end;
endcomp;
run;
ods rtf close;
這個打印出來的參數估計表比較炫,會把顯著的參數用高亮度的黃色標記出來。
Cox PH model
macro 程式如下:
%macro phReg (dsn=, varlist=, numvars=, respvar=, censvar=, censval=,
outdsn=table);
%do j=1 %to &numvars.;
%let var2=%upcase(%scan(&varlist.,&amp;amp;amp;j.,' '));
ods select none;
ods output ParameterEstimates=work.pe&j.;
proc phreg data = &dsn. ;
model &respvar.*&censvar.(&censval.)= &amp;amp;amp;amp;var2./rl;
run;
ods select all;
data pe&j.;
length Independent $15 ;
set pe&j.;
keep Estimate StdErr Independent ProbChiSq HazardRatio
HRLowerCL HRUpperCL;
Independent="&var2.";
if upcase(Variable)="&var2.";
run;
proc sort data=pe&j.;
by Independent;
run;
data all&j.;
merge pe&j. ;
by Independent;
run;
%if &j.=1 %then %do;
data &outdsn.;
set all1;
run;
%end;
%else %do;
data &outdsn.;
set &outdsn. all&amp;amp;amp;j.;
run;
%end;
%end;
%mend phReg;這個 macro 使用到的參數有七個:
- dsn = 資料來源檔
- Varlist = 自變數名稱
- Numvars = 自變數個數
- RespVar = 依變數
- CesnVar = 設限變數名稱
- CensVal = 設限變數值
- outdsn = 輸出參數估計表的資料檔名(預設值=table)
%phReg (dsn =tana.Myeloma,
Varlist =LogBUN HGB Platelet Age LogWBC Frac LogPBM Protein
SCalc,
Numvars =9,
Respvar =Time,
Censvar =VStatus,
Censval =0,
outdsn =phreg);
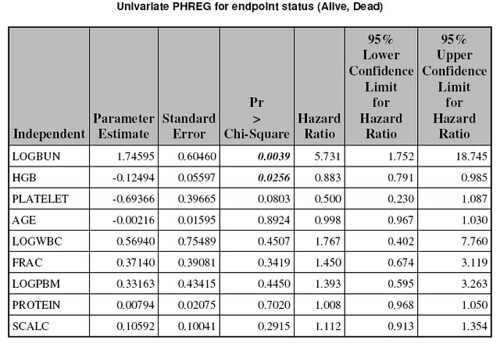
最後還是要用 ODS 和 proc report 把參數估計表存出來:
ods rtf file=''h:\ibm\phreg.doc';
title1 'Univariate PHREG for endpoint status (Alive, Dead)';
proc report data=phreg box nowd split=' ';
column Independent Estimate StdErr ProbChiSq HazardRatio
HRLowerCL HRUpperCL;
define Independent / display;
define Estimate / display;
define StdErr / display;
define ProbChiSq / display;
define HazardRatio / display;
define HRLowerCL / display;
define HRUpperCL / display;
compute probchisq;
if probchisq <= 0.05 then call define('_c4_','style','style=[font_weight=bold font_style=italic]');
endcomp;
run;
ods rtf close;
CONTACT INFORMATION
Your comments and questions are valued and encouraged. Contact the author at:
Angelina Tan
Mayo Clinic, Division of Biostatistics
200 First Street SW
Rochester MN 55905
Phone: 507-284 5743
Fax: 507-266 2477
Email: tan.angelina@mayo.edu
2007年3月4日 星期日
ODS Sttisticl Graphics for Clinical Research
原文載點:http://www2.sas.com/proceedings/sugi31/095-31.pdf
Wei Cheng 於 2006 年的 SUGI 31 發表了一篇關於 ODS (Output Delivery System)繪製高解析度圖形的報告,相當具有建設性!!SAS 在以前最被人詬病的就是複雜的做圖程式還有與所花時間不成比例的低劣品質。這一直到現在還是一些人拒絕使用 SAS 的理由,尤其當不需要使用複雜資料整理和模式配適,而只要簡單生一個 box plot 或 histogram 的時候,讓許多人轉而用 SPSS 或其他統套軟體。現在經由 ODS 就可以在彈指之間,一口氣地畫出很複雜的圖形。現在,就來介紹 ODS/GRAPHICS 最基本的語法:
一開始,需用 ODS GRAPHICS ON 來啟動 ODS/GRAPHICS,後面可以加上一些圖檔格式和名稱的設定,但完全不加也沒有關係。中間就可以放任何的 Data procedure 和 Proc procedure,最後再用 ODS GRAPHICS OFF 來關閉 ODS。
以下就來介紹一些例子。
@ Regression @
上述只是一個很簡單的迴歸程式,但只要在 PROC REG 前後粗體黑字部分的指令,就可以一口氣生出下列圖形:
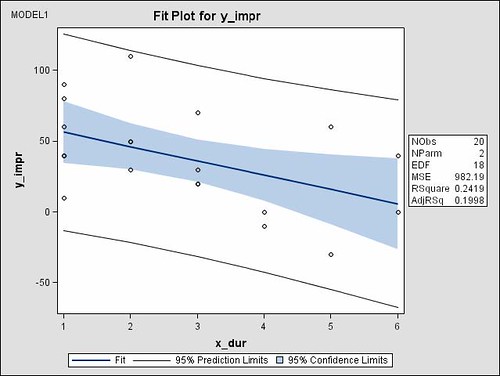
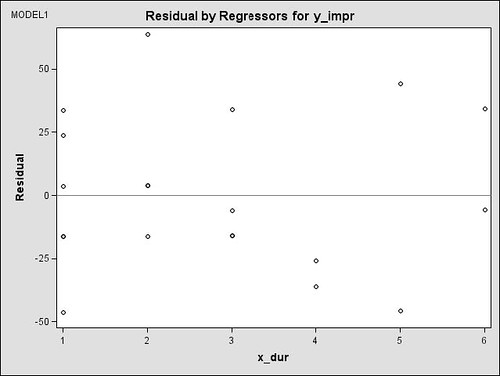
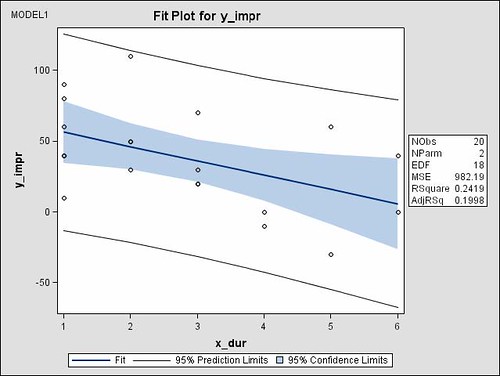
如果想要將這些圖分別儲存的話,只要在 PROC REG 後面加上 plots(unpack) 即可。
附帶一提的是,所有的輸出報表和圖形,因為 ODS HTML 被呼叫的關係,都會被儲存為 html 檔。
另外,可以用 ods select 的指令來指定只生成某一圖檔。以上述圖形而言,想只生成最左邊那張圖,可用 ods select fit 來限定:
如果描繪的點太多,沒有辦法把每一點的 ID 都標示在圖片上,這時可以用 imagefmt = staticmap 的指令,讓觀測值相關訊息可透過滑鼠來顯示。程式如下:
從下圖可知,當滑鼠移到某一點時,就會彈出新的訊息框顯示相關訊息。
總而言之,在 PROC REG 下可以用 ODS/GRAPHICS 產生八種圖形:
• Residuals versus the predicted values
• Studentized residuals versus the predicted values
• Studentized residuals versus the leverage
• Normal quantile plot of the residuals
• Dependent variable values versus the predicted values
• Cook's D versus observation number
• Histogram of the residuals
• A "Residual-Fit" (or RF) plot consisting of side-by-side quantile plots of the centered fit and the residuals.
@ GLM @
GLM 的分析中並沒有用到太多的圖形,但利用 ODS/GRAPHICS 仍可在 PROC GLM 中生出簡單的 box plot。同樣也是只要呼叫 ods graphics 即可。
@ANCOVA @
共變數分析同樣利用 PROC GLM 完成,不同的地方在於模式裡面有個連續變數。因此當 SAS 發現有連續變數放入 PROC GLM 時,就會啟動共變數分析。此時若同時啟動 ODS/GRAPHICS 系統,則會產生 covariance plot。程式和圖形如下:
@ Log Rank Test @
在倖存分析中,可用 PROC LIFETEST 來進行 Log Rank 檢定。同樣地,也可利用 ODS/GRAPHICS 將最後的倖存機率畫出來。
如果想看各細部的圖形,可利用下面的程式來增生:
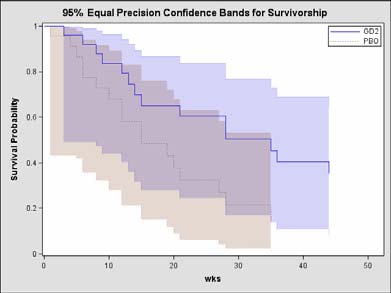
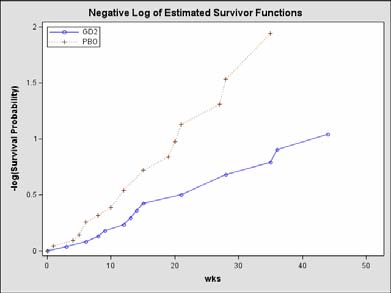
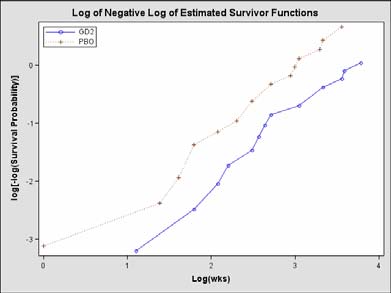
以上所有的 ODS/GRAPHICS 範例,都是用預設的設定來繪圖,而這些設定都放在一個叫做 Stat.Reg.Graphics 的模版裡面。當然,這個模版也是可以做調整的,只要利用 PROC TEMPLATE 的程序,就可以做進一步的更動。PROC TEMPLATE 的基本語法如下:
要嵌入自訂的模版,可在 Data procedure 中加上下面黑色粗體字的那兩行。
文內並沒有詳細說明 PROC TEMPLATE 的所有語法,僅列了兩個例子,因此我只寫其中一個範例在這,詳細情況請參見原文。
@ TWO-SAMPLE T-TEST @
程式:
圖形:
CONTACT INFORMATION
I welcome and appreciate your comments and questions. Contact the author at:
Wei Cheng,
Isis Pharmaceuticals, Inc.,
1896 Rutherford Rd., Carlsbad, CA 92008
(760) 603-3807
Email: wcheng@isisph.com
Wei Cheng 於 2006 年的 SUGI 31 發表了一篇關於 ODS (Output Delivery System)繪製高解析度圖形的報告,相當具有建設性!!SAS 在以前最被人詬病的就是複雜的做圖程式還有與所花時間不成比例的低劣品質。這一直到現在還是一些人拒絕使用 SAS 的理由,尤其當不需要使用複雜資料整理和模式配適,而只要簡單生一個 box plot 或 histogram 的時候,讓許多人轉而用 SPSS 或其他統套軟體。現在經由 ODS 就可以在彈指之間,一口氣地畫出很複雜的圖形。現在,就來介紹 ODS/GRAPHICS 最基本的語法:
ODS GRAPHICS ON [/ MAGEFMT = image-file-type | STATIC | STATICMAP
IMAGENAME = filename RESET ];
procedures or data steps
ODS GRAPHICS OFF;
一開始,需用 ODS GRAPHICS ON 來啟動 ODS/GRAPHICS,後面可以加上一些圖檔格式和名稱的設定,但完全不加也沒有關係。中間就可以放任何的 Data procedure 和 Proc procedure,最後再用 ODS GRAPHICS OFF 來關閉 ODS。
以下就來介紹一些例子。
@ Regression @
ods html;
ods graphics on / imagename = 'regression';
proc reg data = angina;
model y_impr = x_dur;
run;quit;
ods graphics off;
ods html close;
上述只是一個很簡單的迴歸程式,但只要在 PROC REG 前後粗體黑字部分的指令,就可以一口氣生出下列圖形:
如果想要將這些圖分別儲存的話,只要在 PROC REG 後面加上 plots(unpack) 即可。
ods html;
ods graphics on;
proc reg data = angina plots(unpack);
model y_impr = x_dur;
run; quit;
ods graphics off;
ods html close;
附帶一提的是,所有的輸出報表和圖形,因為 ODS HTML 被呼叫的關係,都會被儲存為 html 檔。
另外,可以用 ods select 的指令來指定只生成某一圖檔。以上述圖形而言,想只生成最左邊那張圖,可用 ods select fit 來限定:
ods html;
ods graphics on;
ods select fit;
proc reg data = angina;
model y_impr = x_dur;
run;
quit;
ods graphics off;
ods html close;
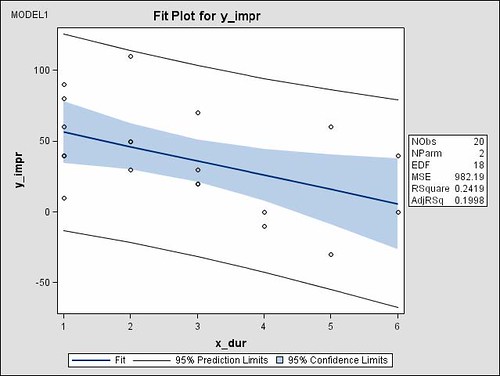
如果描繪的點太多,沒有辦法把每一點的 ID 都標示在圖片上,這時可以用 imagefmt = staticmap 的指令,讓觀測值相關訊息可透過滑鼠來顯示。程式如下:
ods html;
ods graphics on / imagefmt = staticmap;
ods select fit;
proc reg data = angina;
model y_impr = x_dur;
run;
quit;
ods graphics off;
ods html close;
從下圖可知,當滑鼠移到某一點時,就會彈出新的訊息框顯示相關訊息。
總而言之,在 PROC REG 下可以用 ODS/GRAPHICS 產生八種圖形:
• Residuals versus the predicted values
• Studentized residuals versus the predicted values
• Studentized residuals versus the leverage
• Normal quantile plot of the residuals
• Dependent variable values versus the predicted values
• Cook's D versus observation number
• Histogram of the residuals
• A "Residual-Fit" (or RF) plot consisting of side-by-side quantile plots of the centered fit and the residuals.
@ GLM @
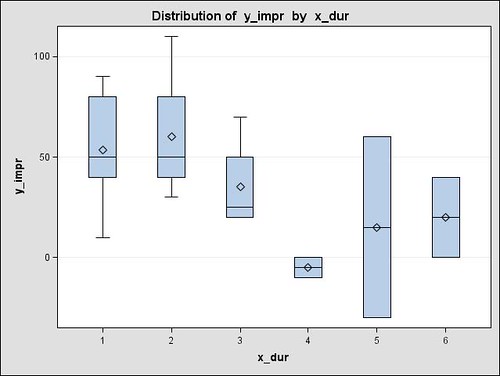
GLM 的分析中並沒有用到太多的圖形,但利用 ODS/GRAPHICS 仍可在 PROC GLM 中生出簡單的 box plot。同樣也是只要呼叫 ods graphics 即可。
ods html;
ods graphics on;
proc glm data = angina;
class x_dur;
model y_impr = x_dur;
run; quit;
ods graphics off;
ods html close;
@ANCOVA @
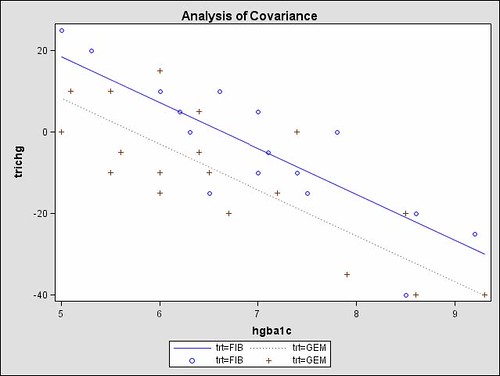
共變數分析同樣利用 PROC GLM 完成,不同的地方在於模式裡面有個連續變數。因此當 SAS 發現有連續變數放入 PROC GLM 時,就會啟動共變數分析。此時若同時啟動 ODS/GRAPHICS 系統,則會產生 covariance plot。程式和圖形如下:
ods html;
ods graphics on / imagename = 'ancova';
proc glm data = tri;
class trt;
model trichg = trt hgba1c / solution;
run; quit;
ods graphics off;
ods html close;
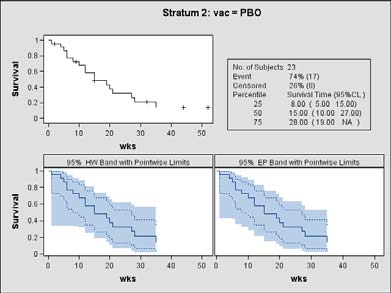
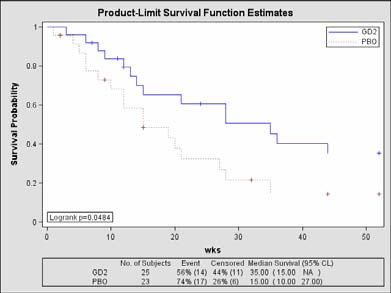
@ Log Rank Test @
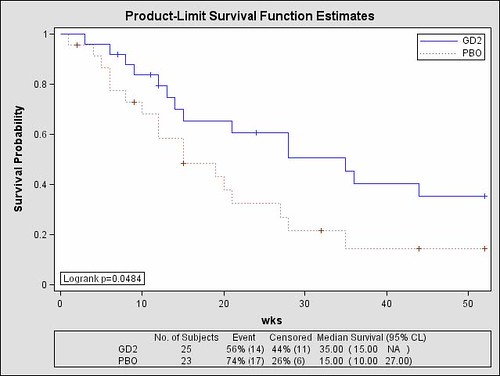
在倖存分析中,可用 PROC LIFETEST 來進行 Log Rank 檢定。同樣地,也可利用 ODS/GRAPHICS 將最後的倖存機率畫出來。
ods html;
ods graphics on / imagename = 'lifetest';
proc lifetest data = hsv;
time wks * cens (1);
strata vac;
run;
ods graphics off;
ods html close;
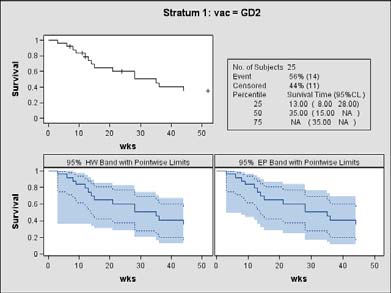
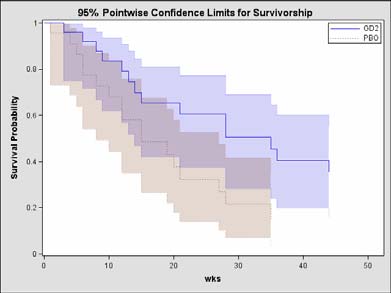
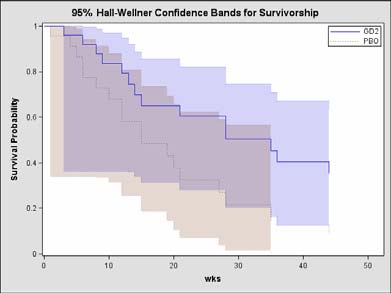
如果想看各細部的圖形,可利用下面的程式來增生:
ods html;
ods graphics on;
proc lifetest data = hsv;
time wks * cens (1);
strata vac;
survival plots = (survival,density,epb,hazard,loglogs,logsurv,hwb,cl,stratum);
run;
ods graphics off;
ods html close;
以上所有的 ODS/GRAPHICS 範例,都是用預設的設定來繪圖,而這些設定都放在一個叫做 Stat.Reg.Graphics 的模版裡面。當然,這個模版也是可以做調整的,只要利用 PROC TEMPLATE 的程序,就可以做進一步的更動。PROC TEMPLATE 的基本語法如下:
PROC TEMPLATE;
DEFINE STATGRAPH name-of-graph-definition;
[declaration-statements;]
[layout-statements;]
[plot-statements;]
[text-statements;]
END;
RUN;
要嵌入自訂的模版,可在 Data procedure 中加上下面黑色粗體字的那兩行。
ODS GRAPHICS ON;
DATA _NULL_;
SET my-data;
FILE PRINT
ODS = (TEMPLATE = “my-graphics-template”);
PUT _ODS_;
RUN;
文內並沒有詳細說明 PROC TEMPLATE 的所有語法,僅列了兩個例子,因此我只寫其中一個範例在這,詳細情況請參見原文。
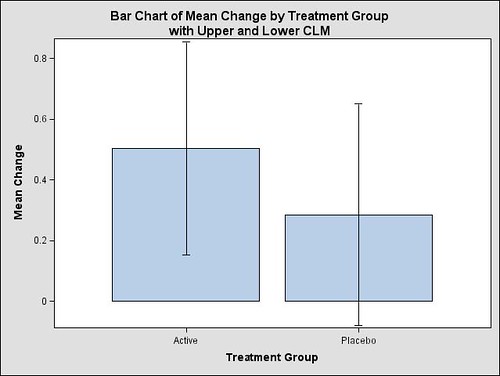
@ TWO-SAMPLE T-TEST @
程式:
proc format;
value $trt 'A' = 'Active' 'P' = 'Placebo';
run;
data fev;
length trtgrp $ 7;
input patno trt $ fev0 fev6 @@;
chg = fev6 - fev0; if chg = . then delete; trtgrp = put(trt, $trt.);
datalines;
101 A 1.35 . 103 A 3.22 3.55 106 A 2.78 3.15
……
;
run;
proc template;
define statgraph mygraphs.meanchg;
layout gridded;
entrytitle 'Bar Chart of Mean Change by Treatment Group' ;
entrytitle 'with Upper and Lower CLM' ;
barchartparm x = trtgrp y = chg_mean / yerrorupper=uclm yerrorlower=lclm;
endlayout;
end;
run;
ods html;
ods graphics on / imagename='meanchange';
proc summary data = fev nway;
class trtgrp;
var chg;
output out = meanchg (drop = _type_ _freq_) mean = chg_mean lclm = lclm uclm = uclm;
run;
data _null_;
set meanchg;
label chg_mean = "Mean Change" trtgrp = "Treatment Group";
uclm = uclm - chg_mean; lclm = chg_mean - lclm;
file print ods = (template='mygraphs.meanchg');
put _ods_;
run;
ods graphics off;
ods html close;
圖形:
CONTACT INFORMATION
I welcome and appreciate your comments and questions. Contact the author at:
Wei Cheng,
Isis Pharmaceuticals, Inc.,
1896 Rutherford Rd., Carlsbad, CA 92008
(760) 603-3807
Email: wcheng@isisph.com
2007年2月26日 星期一
You Can’t Stop Statistics: SAS/STAT Software Keeps Rolling Along
原文載點:http://www2.sas.com/proceedings/sugi31/185-31.pdf
兩位 SAS 內部人員 Maura Stokes 和 Robert Rodriguez在 2006 年的 SUGI 31 發表了一篇相當重要的文章,內容主要在說明最新版本的 SAS 9.2 新功能。其中比較重要的是增加了一些舊版沒有的「內建」的程序,如 GLIMMIX、QUANTREG、GLMSELECT(其實這些可以從 SAS 官網下載外掛程式讓舊版的 SAS 使用)。此外,許多高解析的圖表也一併內建到 ODS 裡面,讓使用者可以輕鬆的繪製一些以往要花很多程式碼才能完成的圖形。由於這篇文章涵蓋的範圍太廣,有新的程式碼,有新的輸出報表和新的高解析圖表,因此就僅拿一些比較「炫」的部分來分享一下。
GENERALIZED LINEAR MIXED MODELS
PROC GLIMMIX 程序在 2005 年就已經發表了,不過僅供外掛,在最新的 SAS 中已經加入了這個相當具有威力的程序。程式的寫法和 PROC MIXED 很像,如下所示:


 連輸出結果都很像:


當然報表解讀又是另一回事情了。想更進一步瞭解 PROC GLIMMIX 的使用方法可以參考
Schabenberger, O. (2005). “Introducing the GLIMMIX procedure for Generalized Linear Models,” Proceedings of the Thirtieth Annual SAS Users Group International Conference. Cary, NC: SAS Institute Inc.
MODEL SELECTION
一般在配適線性模式時,如果程序裡面已經有內建一些選擇變數的 option,如 PROC REG 的 selection statement 下的 method 指令,可以用 forward、backward 和 stepwise 來挑。如果程序裡面沒有這類 option,如 PROC GENMOD,就要用手動的方式來嘗試。PROC GLMSELECT 程序則是針對任何標準的廣義線性模式來做最佳變數選擇。特別要注意的是,他只能處理 univariate response 的情況,而無法處理 multivariate responses。此外,其相關的圖形也已經完全和 ODS 整合起來,所以讓我們來看看這個範例:
此處要特別將 ODS 可以產生的效果提出來一下。此程式啟動了 ODS 功能(紅色標示處),並且在 PROC GLMSELECT 後加上 plots=all 的選項,這樣 SAS 就會自動產生所有在此程序可以生出來的圖形。當然,如果妳只想指定某一張圖形的畫,就要指定特定名稱。這些名稱都有紀錄在 SAS 官網上面,供使用者免費下載。如果指定 plots=criterionpanel ,則 SAS 只會產生 Criteron Panel 這張圖。該圖秀出所有可供判斷最佳模式的圖表。為免仍有人看不懂這張表,SAS 乾脆在圖上標上☆符號,告訴使用者這個就是最佳模式!如下圖所示:


ANNOUNCING NEW SOFTWARE: SAS STAT STUDIO
新版 SAS 還可以呼叫一個新的軟體名為 SAS STAT STUDIO。這整合了包含 SAS 資料、程式、輸出報表和圖形,且可以利用表單點選的方式來完成分析(類似SPSS吧)。但文內並沒有特別敘述如何操作,只秀了一張很 fancy 的圖,不過我們可以拭目以待。

EFFECT PLOT IN PROC LOGISTIC
其實 logistic regression model 並沒有什麼太重要的圖需要特別繪製,因為重點都是在如何解釋那個 Odds Ratio。不過新的 ODS 仍舊聊勝於無地加了幾張圖。只要在 PROC LOGISTIC 後面指定 plots option 就可完成。裡面用了一個範例如下:
這個程式可以生出一張 Predicted Probabilities Plot:

BAYESIAN ANALYSIS FOR THE PIECEWISE EXPONENTIAL MODEL IN PROC PHREG
這回連 PROC PHREG 裡面都加入了新的指令可以用 Bayesian analysis 來配適 piecewise exponential model。我在 2005 年修 Bayesian analysis 時有學到這段,可是當時只有 WINBUGS 這個軟體可以比較有效率的估計參數和繪製圖表(但語法還是很難學,而且還要上工作站去跑程式)。現在 SAS 也加入了這個功能,方法相當簡單:
令人訝異地,只需要補上紅色那段程式碼,就可以完全搞定。要產生相關圖表甚至不需要在 PROC PHREG 後面加上 plots 選項,只要直接呼叫出 ODS 即可。
在這裡僅列出圖表。

想要進一步地瞭解貝氏理論在倖存分析上的應用,可以參考下面這本教科書:
Ibrahim, J. G., Chen, M., and Sinha, D. (2001). Bayesian Survival Analysis, New York: Springer.
附帶一提的是,本書的作者 Joe Ibrahim 是北卡大生統系的貝氏理論權威,當年教我貝氏理論和高等數理統計學的就是這位大師。Joe 人是不錯,可是他的考試每次沒耗個六七個小時是不可能寫的完的。。。。。
BAYESIAN ANALYSIS FOR THE POISSON REGRESSION MODEL IN PROC GENMOD
同樣地,在 PROC GENMOD 下,貝氏理論也可以輕鬆套用了!^^
這回連 bayes statement 後面啥東西都不用加了!Orz
THINGS GO BETTER WITH PROC TTEST
連最簡單的 T-test 都有新的花樣!除了使用 ODS 可以產生長條圖和常態曲線外,一個很炫的「交叉分析」也出現在報表當中。讓我們來先看看程式怎樣寫:
紅色那段程式碼就是 SAS 9.2 為 PROC TTEST 程序新增的指令。這個指令新到連目前 SAS 線上手冊的 PROC TTEST 程序指令集都還沒有加入。
他會產生下面這些圖形:


REGRESSION DIAGNOSTICS FOR GEE MODELS IN THE GENMOD PROCEDURE
早期要使用 GEE 在 PROC GENMOD 時,並沒有任何關於模式診斷的指令可供使用。我和一位老師討論過為什麼大家在做 GENMOD 時不重視模式診斷,他自己也說不上來,總之結論就是這一部份的理論很晚才發展出來,因此 SAS 在一開始時沒有加入相關程式。這部分的理論大約是在 90 年代末期才陸續有一些論文發表出來。我們先來看一下程式:
紅色部分的程式碼可以呼叫大家最經常拿來鑑定 influential data 的 Cooks' D 值。如下所示:

關於這部分的理論,可以參考下面這篇論文:
Preisser JS, Qaqish BF (1999), “Robust Regression for Clustered Data with Application to Binary Responses”, Biometrics, 55, 574–579.
其中 John Preisser 是我的 committee member 之一,而 Qaqish 是他的博士論文指導教授。Qaqish 本人以前是 GEE 的發明者之一梁賡義博士的博士論文指導學生。Preisser 和 Qaqish 目前仍在北卡大生統系執教著。
POWER AND SAMPLE SIZE APPLICATION
SAS 其實已經有可以計算 power analysis 的程序,如 PROC POWER 和 PROC GLMPOWER。其中 PROC GLMPOWER 在 9.2 版前要外掛。文內並沒有特別說 9.2 版會加入這個程序。不過倒是有研發一個視窗介面的程式讓使用者用點選的方式就可以完成 power analysis。這對於一些對程式不熟悉的人來說應該是相當方便。
圖就不另外列了,文章裡面有。
ENHANCEMENTS TO SAS/STAT PROCEDURES
除此之外,還有其他一些林林總總的新增項目,僅列出我覺得比較重要的:
兩位 SAS 內部人員 Maura Stokes 和 Robert Rodriguez在 2006 年的 SUGI 31 發表了一篇相當重要的文章,內容主要在說明最新版本的 SAS 9.2 新功能。其中比較重要的是增加了一些舊版沒有的「內建」的程序,如 GLIMMIX、QUANTREG、GLMSELECT(其實這些可以從 SAS 官網下載外掛程式讓舊版的 SAS 使用)。此外,許多高解析的圖表也一併內建到 ODS 裡面,讓使用者可以輕鬆的繪製一些以往要花很多程式碼才能完成的圖形。由於這篇文章涵蓋的範圍太廣,有新的程式碼,有新的輸出報表和新的高解析圖表,因此就僅拿一些比較「炫」的部分來分享一下。
GENERALIZED LINEAR MIXED MODELS
PROC GLIMMIX 程序在 2005 年就已經發表了,不過僅供外掛,在最新的 SAS 中已經加入了這個相當具有威力的程序。程式的寫法和 PROC MIXED 很像,如下所示:
proc glimmix data=Neuralgia; class Treatment Sex;
model Pain= Treatment Age Treatment*Age /solution oddsratio;
ods select ParameterEstimates OddsRatios;
run;
連輸出結果都很像:

當然報表解讀又是另一回事情了。想更進一步瞭解 PROC GLIMMIX 的使用方法可以參考
Schabenberger, O. (2005). “Introducing the GLIMMIX procedure for Generalized Linear Models,” Proceedings of the Thirtieth Annual SAS Users Group International Conference. Cary, NC: SAS Institute Inc.
MODEL SELECTION
一般在配適線性模式時,如果程序裡面已經有內建一些選擇變數的 option,如 PROC REG 的 selection statement 下的 method 指令,可以用 forward、backward 和 stepwise 來挑。如果程序裡面沒有這類 option,如 PROC GENMOD,就要用手動的方式來嘗試。PROC GLMSELECT 程序則是針對任何標準的廣義線性模式來做最佳變數選擇。特別要注意的是,他只能處理 univariate response 的情況,而無法處理 multivariate responses。此外,其相關的圖形也已經完全和 ODS 整合起來,所以讓我們來看看這個範例:
ods graphics on;
proc glmselect data=baseball plots=all;
class league division; model logSalary = nAtBat nHits nHome nRuns nRBI nBB yrMajor crAtBat crHits crHome crRuns crRbi crBB league division nOuts nAssts nError / details=all selection=stepwise(select=sl) stats=all;
run;
ods graphics off;
此處要特別將 ODS 可以產生的效果提出來一下。此程式啟動了 ODS 功能(紅色標示處),並且在 PROC GLMSELECT 後加上 plots=all 的選項,這樣 SAS 就會自動產生所有在此程序可以生出來的圖形。當然,如果妳只想指定某一張圖形的畫,就要指定特定名稱。這些名稱都有紀錄在 SAS 官網上面,供使用者免費下載。如果指定 plots=criterionpanel ,則 SAS 只會產生 Criteron Panel 這張圖。該圖秀出所有可供判斷最佳模式的圖表。為免仍有人看不懂這張表,SAS 乾脆在圖上標上☆符號,告訴使用者這個就是最佳模式!如下圖所示:

ANNOUNCING NEW SOFTWARE: SAS STAT STUDIO
新版 SAS 還可以呼叫一個新的軟體名為 SAS STAT STUDIO。這整合了包含 SAS 資料、程式、輸出報表和圖形,且可以利用表單點選的方式來完成分析(類似SPSS吧)。但文內並沒有特別敘述如何操作,只秀了一張很 fancy 的圖,不過我們可以拭目以待。

EFFECT PLOT IN PROC LOGISTIC
其實 logistic regression model 並沒有什麼太重要的圖需要特別繪製,因為重點都是在如何解釋那個 Odds Ratio。不過新的 ODS 仍舊聊勝於無地加了幾張圖。只要在 PROC LOGISTIC 後面指定 plots option 就可完成。裡面用了一個範例如下:
ods graphics on;
proc logistic data=one plots=(effect(clband yview=(.5,1)));
class Treatment Diagnosis / param=ref; model Cured/N= Diagnosis Treatment;
ods select effectplot;
run;
ods graphics off;
這個程式可以生出一張 Predicted Probabilities Plot:

BAYESIAN ANALYSIS FOR THE PIECEWISE EXPONENTIAL MODEL IN PROC PHREG
這回連 PROC PHREG 裡面都加入了新的指令可以用 Bayesian analysis 來配適 piecewise exponential model。我在 2005 年修 Bayesian analysis 時有學到這段,可是當時只有 WINBUGS 這個軟體可以比較有效率的估計參數和繪製圖表(但語法還是很難學,而且還要上工作站去跑程式)。現在 SAS 也加入了這個功能,方法相當簡單:
ods graphics on;
proc phreg data=Exposed;
model Days*Status(0)=Treatment Sex;
bayes piecewise=loghazard;
run;
ods graphics off;
令人訝異地,只需要補上紅色那段程式碼,就可以完全搞定。要產生相關圖表甚至不需要在 PROC PHREG 後面加上 plots 選項,只要直接呼叫出 ODS 即可。
在這裡僅列出圖表。

想要進一步地瞭解貝氏理論在倖存分析上的應用,可以參考下面這本教科書:
Ibrahim, J. G., Chen, M., and Sinha, D. (2001). Bayesian Survival Analysis, New York: Springer.
附帶一提的是,本書的作者 Joe Ibrahim 是北卡大生統系的貝氏理論權威,當年教我貝氏理論和高等數理統計學的就是這位大師。Joe 人是不錯,可是他的考試每次沒耗個六七個小時是不可能寫的完的。。。。。
BAYESIAN ANALYSIS FOR THE POISSON REGRESSION MODEL IN PROC GENMOD
同樣地,在 PROC GENMOD 下,貝氏理論也可以輕鬆套用了!^^
ods graphics on;
proc genmod data=liver;
model y = x1-x6 / dist=poisson;
bayes;
run;
ods graphics off;
這回連 bayes statement 後面啥東西都不用加了!Orz
THINGS GO BETTER WITH PROC TTEST
連最簡單的 T-test 都有新的花樣!除了使用 ODS 可以產生長條圖和常態曲線外,一個很炫的「交叉分析」也出現在報表當中。讓我們來先看看程式怎樣寫:
ods graphics on;
proc ttest data=asthma;
var PEF1 PEF2 / crossover= (Drug1 Drug2);
run;
ods graphics off;
紅色那段程式碼就是 SAS 9.2 為 PROC TTEST 程序新增的指令。這個指令新到連目前 SAS 線上手冊的 PROC TTEST 程序指令集都還沒有加入。
他會產生下面這些圖形:


REGRESSION DIAGNOSTICS FOR GEE MODELS IN THE GENMOD PROCEDURE
早期要使用 GEE 在 PROC GENMOD 時,並沒有任何關於模式診斷的指令可供使用。我和一位老師討論過為什麼大家在做 GENMOD 時不重視模式診斷,他自己也說不上來,總之結論就是這一部份的理論很晚才發展出來,因此 SAS 在一開始時沒有加入相關程式。這部分的理論大約是在 90 年代末期才陸續有一些論文發表出來。我們先來看一下程式:
ods graphics on;
proc genmod data = preqaq99 descending plots=(cooksd clustercooksd);
class pract_id ;
model bothered = female age dayacc severe toilet/d=bin itprint ;
repeated sub=pract_id/corr=exch modelse;
run;
ods graphics off;
紅色部分的程式碼可以呼叫大家最經常拿來鑑定 influential data 的 Cooks' D 值。如下所示:

關於這部分的理論,可以參考下面這篇論文:
Preisser JS, Qaqish BF (1999), “Robust Regression for Clustered Data with Application to Binary Responses”, Biometrics, 55, 574–579.
其中 John Preisser 是我的 committee member 之一,而 Qaqish 是他的博士論文指導教授。Qaqish 本人以前是 GEE 的發明者之一梁賡義博士的博士論文指導學生。Preisser 和 Qaqish 目前仍在北卡大生統系執教著。
POWER AND SAMPLE SIZE APPLICATION
SAS 其實已經有可以計算 power analysis 的程序,如 PROC POWER 和 PROC GLMPOWER。其中 PROC GLMPOWER 在 9.2 版前要外掛。文內並沒有特別說 9.2 版會加入這個程序。不過倒是有研發一個視窗介面的程式讓使用者用點選的方式就可以完成 power analysis。這對於一些對程式不熟悉的人來說應該是相當方便。
圖就不另外列了,文章裡面有。
ENHANCEMENTS TO SAS/STAT PROCEDURES
除此之外,還有其他一些林林總總的新增項目,僅列出我覺得比較重要的:
- PROC GENMOD 新增可以做 model selection criteria 的 AIC 和 QIC 值。
- PROC MIXED 新增 method=laplace。
- 在 survery analysis 程序中加入 Jackknife 法。
- PROC PHREG 新增 class statement。
- 新增 PROC QUANTREG 程序。
- PROC NPAR1WAY 新增 conover test 和中位數差的 Hodges-Lehmann 信賴區間。
- PROC GENMOD 和 PROC PHREG 可算出 cumulative residuals。
訂閱:
文章 (Atom)